
从穿搭照片生成搭配反馈
学习一个可交付的工作流:准备穿搭图片与样本板、用视觉模型提取服饰/面料标签、将结构化描述交给 Codex 生成有趣的穿搭点评与社媒文案,输出可嵌入博主工作流的 Skill(含必要前提与需核实项)。
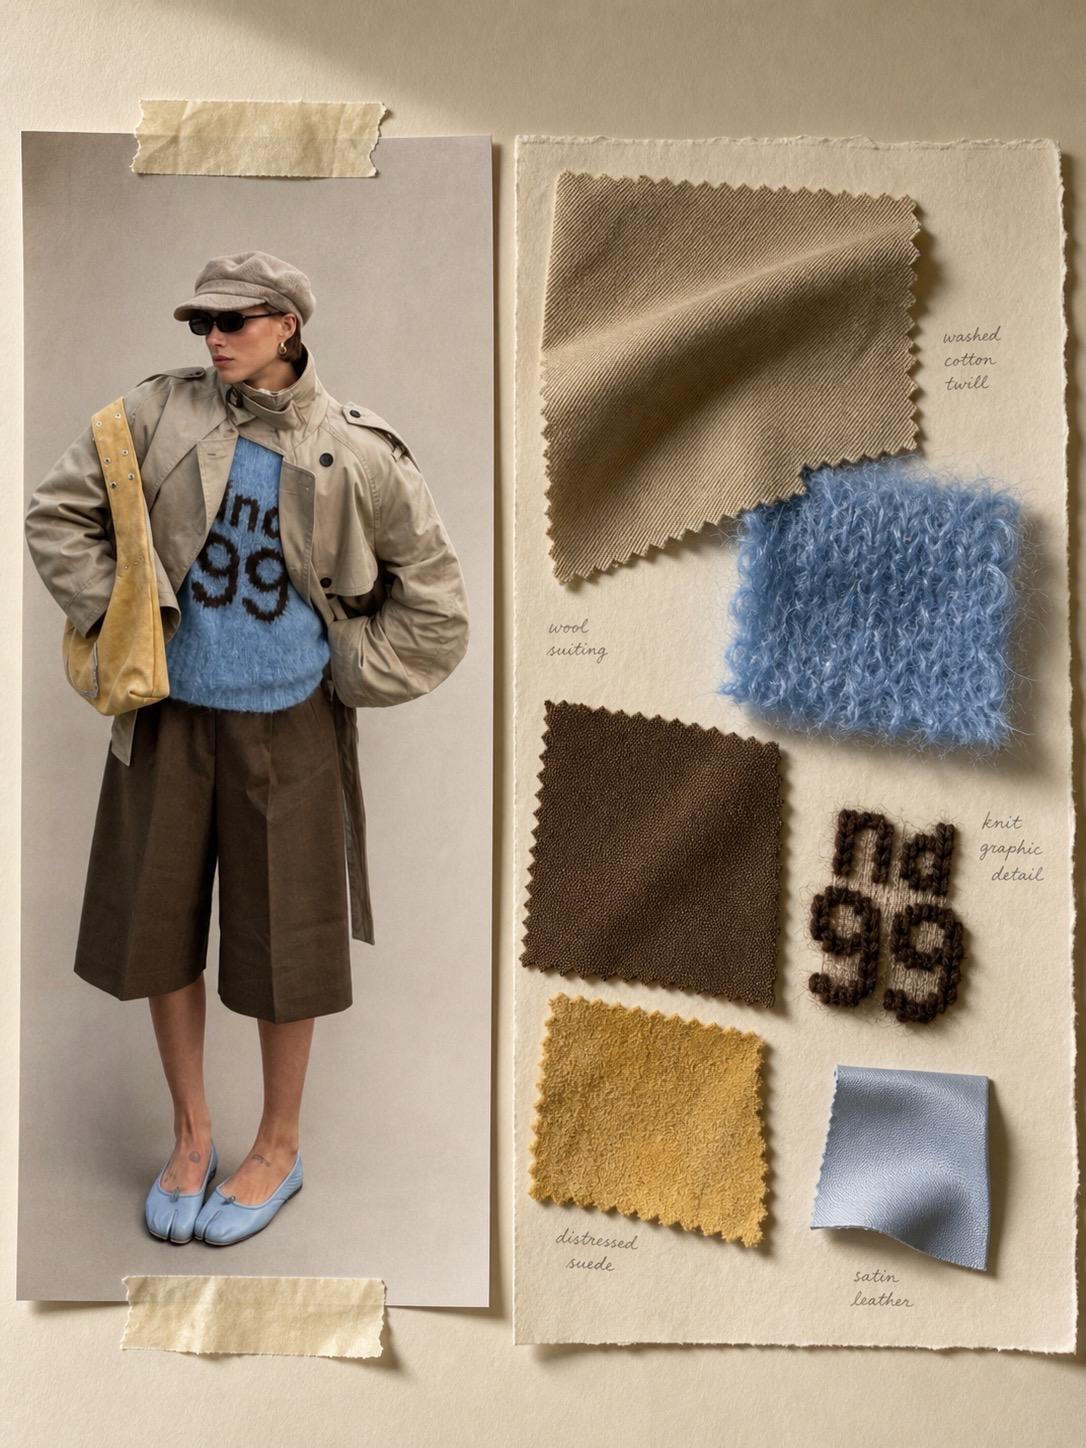
图片解读
第 1 张 — 图片证据整理
一、可读文字(原文按大致位置描述)
- 右侧纸张顶部靠近浅褐色布样:washed cotton twill
- 右侧浅蓝色毛絮布样左下方(靠近顶部中部):wool suiting
- 右侧中部靠近棕色毛线图样右侧:knit graphic detail
- 右侧中下靠近黄色麂皮样:distressed suede
- 右下角靠近浅蓝色缎面样:satin leather
二、界面步骤 / 图表数据
- 无界面步骤(不是界面截图);无图表数据。
三、可见事实(仅列出肉眼可见的客观现象)
- 整体构图为左侧一张竖向人物照片,右侧为贴在纸上的多种面料样本与手写标签的拼贴板(moodboard/样本板类布局)。
- 左侧照片(人物部分):
- 模特着装:浅米色鸭舌/贝雷帽、深色太阳镜、米色短款风衣或外套、浅蓝色绒毛针织毛衣(带深色图文/字样)、深褐色宽阔裤或及膝短裙裤(culottes 风格)、浅蓝色分趾鞋(类似 tabi 鞋型)、肩挎黄色/金黄色绒面包袋。
- 模特配饰:耳环(可见环形耳环)、墨镜。
- 照片上下两端有胶带效果(上方一条、下方一条)将照片“固定”在背景纸上(拼贴视觉元素)。
- 模特脚背上可见两个小圆形标记或纹身(在两脚上方靠近脚面处)。
- 右侧样本板(从上到下、左到右排列的样本和标签):
- 顶端:浅褐色/卡其色织物样本(边缘锯齿剪裁)旁标注“washed cotton twill”。
- 右中上:浅蓝色绒毛编织/毛线样本(方形,蓬松感明显)。
- 左中:深褐色布样(方形,边缘锯齿剪裁),旁或下方标注“wool suiting”。
- 右中:深褐色毛线编织成的图形/文字样本(立体毛线效果),旁标注“knit graphic detail”。
- 左下:黄色/黄褐色麂皮质感样本(方形,边缘锯齿剪裁),下方标注“distressed suede”。
- 右下:浅蓝灰色光泽面料样本(小片,折皱呈现缎面光泽),下方标注“satin leather”。
- 右侧样本板底色为浅米色手感纸张,纸张边缘有不规则撕裂效果;样本多为边缘锯齿状裁切,呈样品展示风格。
- 整图色调以米色、卡其、褐色、浅蓝、黄色为主,呈现面料拼配参考板的感觉。
四、无法辨认或不确定的内容(标明具体位置与不确定原因)
- 毛衣上的棕色文字/图案(位于左侧人物照片浅蓝色毛衣上):字符形状似乎为“na99”或“nagg”等组合,但字形模糊且为毛线效果,无法确认为具体字母/数字组合——标注为“无法确定:毛衣上棕色字样(疑似 'na99' 或 'nagg')”。
- 右侧深褐色毛线编织图样(近“knit graphic detail”标签):其具体字符或图形也与毛衣上的相似,但单个字符判读不确定(可能是相同的“na99”图案),无法完全确认具体字母或数字。
- 人物面部表情、肤色细节、年龄、身份等个人识别信息不做判断(图像提供但不用于识别)。
- 任何小的手写笔迹细节(如字迹笔画细微处)在照片分辨率或字体笔触处可能存在微小不确定性,但上述已列出的标签文字总体可读。
五、推测(明确标注为推测,不作为事实)
- 该图像整体可能为服装/面料的搭配灵感板或产品展示板(moodboard)——基于样本板布局和手写标签风格作此推测。
- 胶带、撕裂纸边和样本锯齿边为刻意的视觉拼贴设计元素,用于展示样本相互搭配关系(为设计呈现用)——为推测。
- 模特鞋型像日本分趾 tabi 风格鞋,推测为特意与浅蓝毛衣呼应的配色选择。
六、其他注意事项
- 图片中有真人(模特),不做身份识别或人物信息推断。
- 若需进一步逐像素或更高精度的文字识别(例如确认毛衣上具体字母/数字),可提供更高分辨率或局部放大图以便复核。
SkillPI 作品解读
作品用途与解读:
- 用途:这是为穿搭博主或时尚内容创作者制作的一个“有趣/好玩”的 Skill 概念示例,目标是把穿搭图片输入到系统后,得到以面料、配色或幽默风格呈现的反馈或描述(例如标签、情绪板元素、趣味文案)。
图片证据要点:
- 图片是左侧人物穿搭照与右侧样本板并列的拼贴构成,右侧样本板上有可读的面料标签(washed cotton twill、wool suiting、knit graphic detail、distressed suede、satin leather),这为自动识别面料或生成描述提供了显性文本线索。
- 左侧服装细节(帽子、风衣、毛衣、culottes、分趾鞋、黄色绒面包袋)可作为风格与配色特征的标注目标。
可复现步骤(概念性、仅列可实现的工作流,需按己方技术栈调整):
1. 数据准备:收集穿搭照片与对应的样本板/标签,整理为训练或提示模板用例,确保图像分辨率与局部放大图可供视觉识别。保留合法使用权与模特同意。
2. 视觉解析:用图像识别或视觉特征提取模型识别服装件类(帽子、外套、针织衫、裤/裙、鞋、包)、颜色与纹理,并识别图像中可读文本(样本板标签)。
3. 结构化描述:将识别结果归一化为结构化数据(如 garment:type、color、material、accessory、moodboard:labels)。
4. 文本生成(使用 Codex 或代码/提示引擎):把结构化描述作为输入,设计 Prompt 或模板让生成器输出“有趣/好玩”的穿搭反馈(示例:标签、简短风格点评、搭配建议、社媒文案片段或 moodboard 风格说明)。
5. 输出与封装:将生成文本、标签与可选的图像标注一起打包为可嵌入到博主工作流的 Skill(例如:社媒草稿、图注、产品或面料说明片段)。
复现前提(必须具备的条件):
- 能处理图片的视觉识别能力(OCR/文字识别、服饰/材质分类、颜色/纹理提取)。
- 有权限使用 Codex 或其他文本/代码生成 API;若需要多模态能力,需确认所用模型支持将视觉描述与文本生成结合。
- 足够清晰的图片或可提供局部放大图以便识别毛衣上的细小文字与样本板标签。
- 合法的内容使用许可与对模特/受访者的隐私与同意管理(图片中有真人)。
待核实项(不可直接假设或需进一步确认的要点):
- Codex 是否能直接接收图像作为输入:如果不能,需先用视觉模型将图像转为结构化文字描述,再把文本交给 Codex 生成有趣反馈。
- 毛衣上棕色字样与右侧毛线图样的精确文字(输入图片分辨率目前不足以确认,需更高分辨率或放大图以 OCR 复核)。
- 目标 Skill 的实时性与接口:需确认部署平台对调用频率、延迟与媒体上传的限制。
- 可用模型的输出风格与安全过滤:需测试生成文本的语气、敏感词过滤与版权合规性。
注意事项:
- 本解读基于所给摘要与图片证据整理得出,未在真实系统中执行过该 Skill 的端到端演示;所有操作均需在具备相应模型与权限的环境中验证,避免未经授权地处理含有可识别个人的图像。