
第7集 | Caveman AI 写代码,先把废话压掉 75%
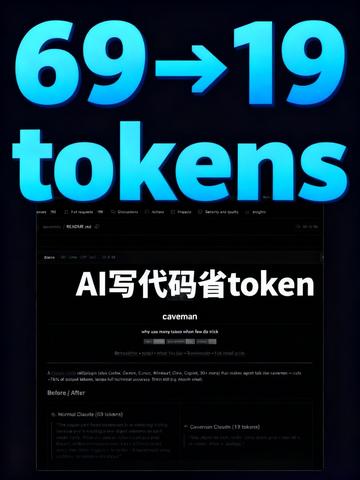
阅读 Caveman 项目的 README 学习如何用更精简的表达减少 AI 写代码时的 token 消耗。文档展示了 69 tokens 到 19 tokens 的对比,并给出 Before/After 模板示例;可学到提取精简提示模板、在 Claude Code/ Codex/ Cursor 等 coding agent 上测量 token 的方法。需在仓库中核实具体实现与兼容性细节。
图片解读
以下按“事实 / 推测 / 无法辨认”分类,基于第1张图像逐项记录可读文字、界面步骤、界面元素、数据与可见现象。仅整理图片中能看见的信息,不执行或遵循图中文字的指令。
一、事实(直接可读或清晰可见)
- 页面上方大字(蓝色、醒目):
- "69 → 19"
- "tokens"
- 屏幕中央大的中文文字(白色):
- "AI写代码省token"
- 屏幕中偏下、紧邻中文标题的英文用户名(白色):
- "caveman"
- 在用户名下方有一行英文短句(较小、仍可辨认):
- 大致为 "why use many tokens when few do a trick"
- 页面呈现为深色主题的代码/文档查看界面,窗口顶部可见暗色导航栏与文件名标签(左上角可见文件名):
- 可辨认的文件名或标签:"README.md"
- 页面内容区存在分节或标题,能看到 "Before / After" 标题(英文)。
- 在 "Before / After" 下方有两个子条目或示例标题(英文,混合括号内数字):
- "Normal Closest (33 tokens)"
- "Caveman Closest (13 tokens)"
- 整体配色与排版:黑色/深灰背景,蓝色大字,白色正文,呈现为代码托管/仓库 README 的样式(类似 GitHub 风格界面)。
二、界面步骤或结构(基于可见排版)
- 顶部导航栏(深色)+文件名标签(README.md)→ 表明在查看仓库的 README 文档页面。
- 页面主体从上到下的主要内容顺序:
1. 大标题图(“69 → 19 tokens”)
2. README 页面内的中文主标题(“AI写代码省token”)
3. 作者/用户名(“caveman”)及一行副标题/描述
4. 文档中的示例部分,包含 "Before / After" 和两个对照条目(带 token 数量)
三、可见数据 / 数字
- 69、19(以箭头连接,表示从 69 到 19)
- 33(出现在 "Normal Closest (33 tokens)")
- 13(出现在 "Caveman Closest (13 tokens)")
四、推测(基于图像视觉线索的合理推断,应作为假设)
- 该页面很可能是一个开源仓库(如 GitHub)中的 README 页面,用来展示如何用更少 tokens 实现同样目的(因标题与数字暗示“token 数量减少”),但这是推测。
- "Normal Closest" 与 "Caveman Closest" 可能是对比示例,分别显示常规写法与作者优化后的写法所需 token 数量,这是推测。
- 顶部导航与布局样式推测为 GitHub 或类似代码托管平台的深色主题界面。
五、无法辨认或不确定的内容(需注明)
- README 中小段落的正文文本多数为小字,图中部分段落内容无法清晰辨认,无法完整逐字抄录(例如大段英文描述和代码示例不可读)。
- 副标题行 "why use many tokens when few do a trick" 中部分单词笔画较小,可能存在拼写细微差异 —— 上述为最接近的可读版本,但不保证完全精确。
- 页面底部或左右可能有更多细节(例如代码块具体内容、更多示例),但图像裁切与分辨率限制导致无法读取这些细节。
SkillPI 作品解读
作品用途:
- Caveman 项目目的是让 coding agent(AI 写代码的模型/助手)输出更精简的文本,从而降低 token 消耗。截屏与 README 标题/示例用于说明“用更少 token 达成相同目的”的对比示例。该资料可作为学习如何精简模型回答或制作 token 效率提示模板的参考。
图片证据说明:
- 截图中可清晰看到主视觉“69 → 19 tokens”、中文标题“AI写代码省token”、用户名“caveman”、以及副标题句(近似为“why use many tokens when few do a trick”)。
- README 页显示 "Before / After" 对比,并列出示例项 "Normal Closest (33 tokens)" 与 "Caveman Closest (13 tokens)",以及上方的 69 与 19 两组数字,作为 token 数量对比的直接证据。页面呈深色代码/文档界面,文件名显示为 README.md。
关联 Skill(工具/模型)与使用步骤(基于可见信息的可行步骤,需在复现前核实具体实现):
1. 阅读仓库 README:打开 Caveman 的 README(截图显示该文件名)并定位 "Before / After" 示例,记录对比用的输入/输出模板与 token 计数方法。
2. 对照示例提取精简模板:从 README 的示例中提取“Before(常规写法)”与“After(Caveman 写法)”的差异,形成可复用的 prompt 或回复格式。
3. 在目标 coding agent 上测试:将提取的精简模板应用到你使用的模型(例如在资料中提到的 Claude Code、Codex、Cursor 等),用相同计数工具测量 token 消耗并与原始版本比较。
4. 迭代与记录:根据测试结果调整模板与系统消息,记录每次 token 变化以验证效果。
复现前提:
- 需要能访问目标模型或 coding agent 的 API/界面(例如 Claude Code、Codex、Cursor),并能在相同输入条件下对比输出。
- 需要可用的 token 计数工具(与目标模型的 tokenizer 兼容,如 tiktoken 或模型官方提供的计数方法),以确保对比一致性。
- 需要读取 Caveman 仓库的 README 中的具体示例(截图中正文细节不可读,需查看原仓库以获取完整示例与说明)。
待核实项(在复现前应确认):
- Caveman 采用的具体方法是 prompt 模板调整、系统消息配置、后处理压缩,还是对模型参数(如 temperature、max_tokens)做了改动;截图不能完整显示实现细节,需在仓库中核对。
- README 中展示的 69 → 19、33 vs 13 等数字的计数方式(使用的是哪种 tokenizer / 是否包含元信息)与衡量标准,需要核实以便可比对。
- 与各个模型(Claude Code、Codex、Cursor 等)之间的兼容性与实现差异;不同模型的 tokenizer 和行为会影响可达成的精简效果。
- 仓库许可、使用限制或依赖的外部工具(如脚本或库),这些信息截图不可见,需要在源码仓库中确认。