
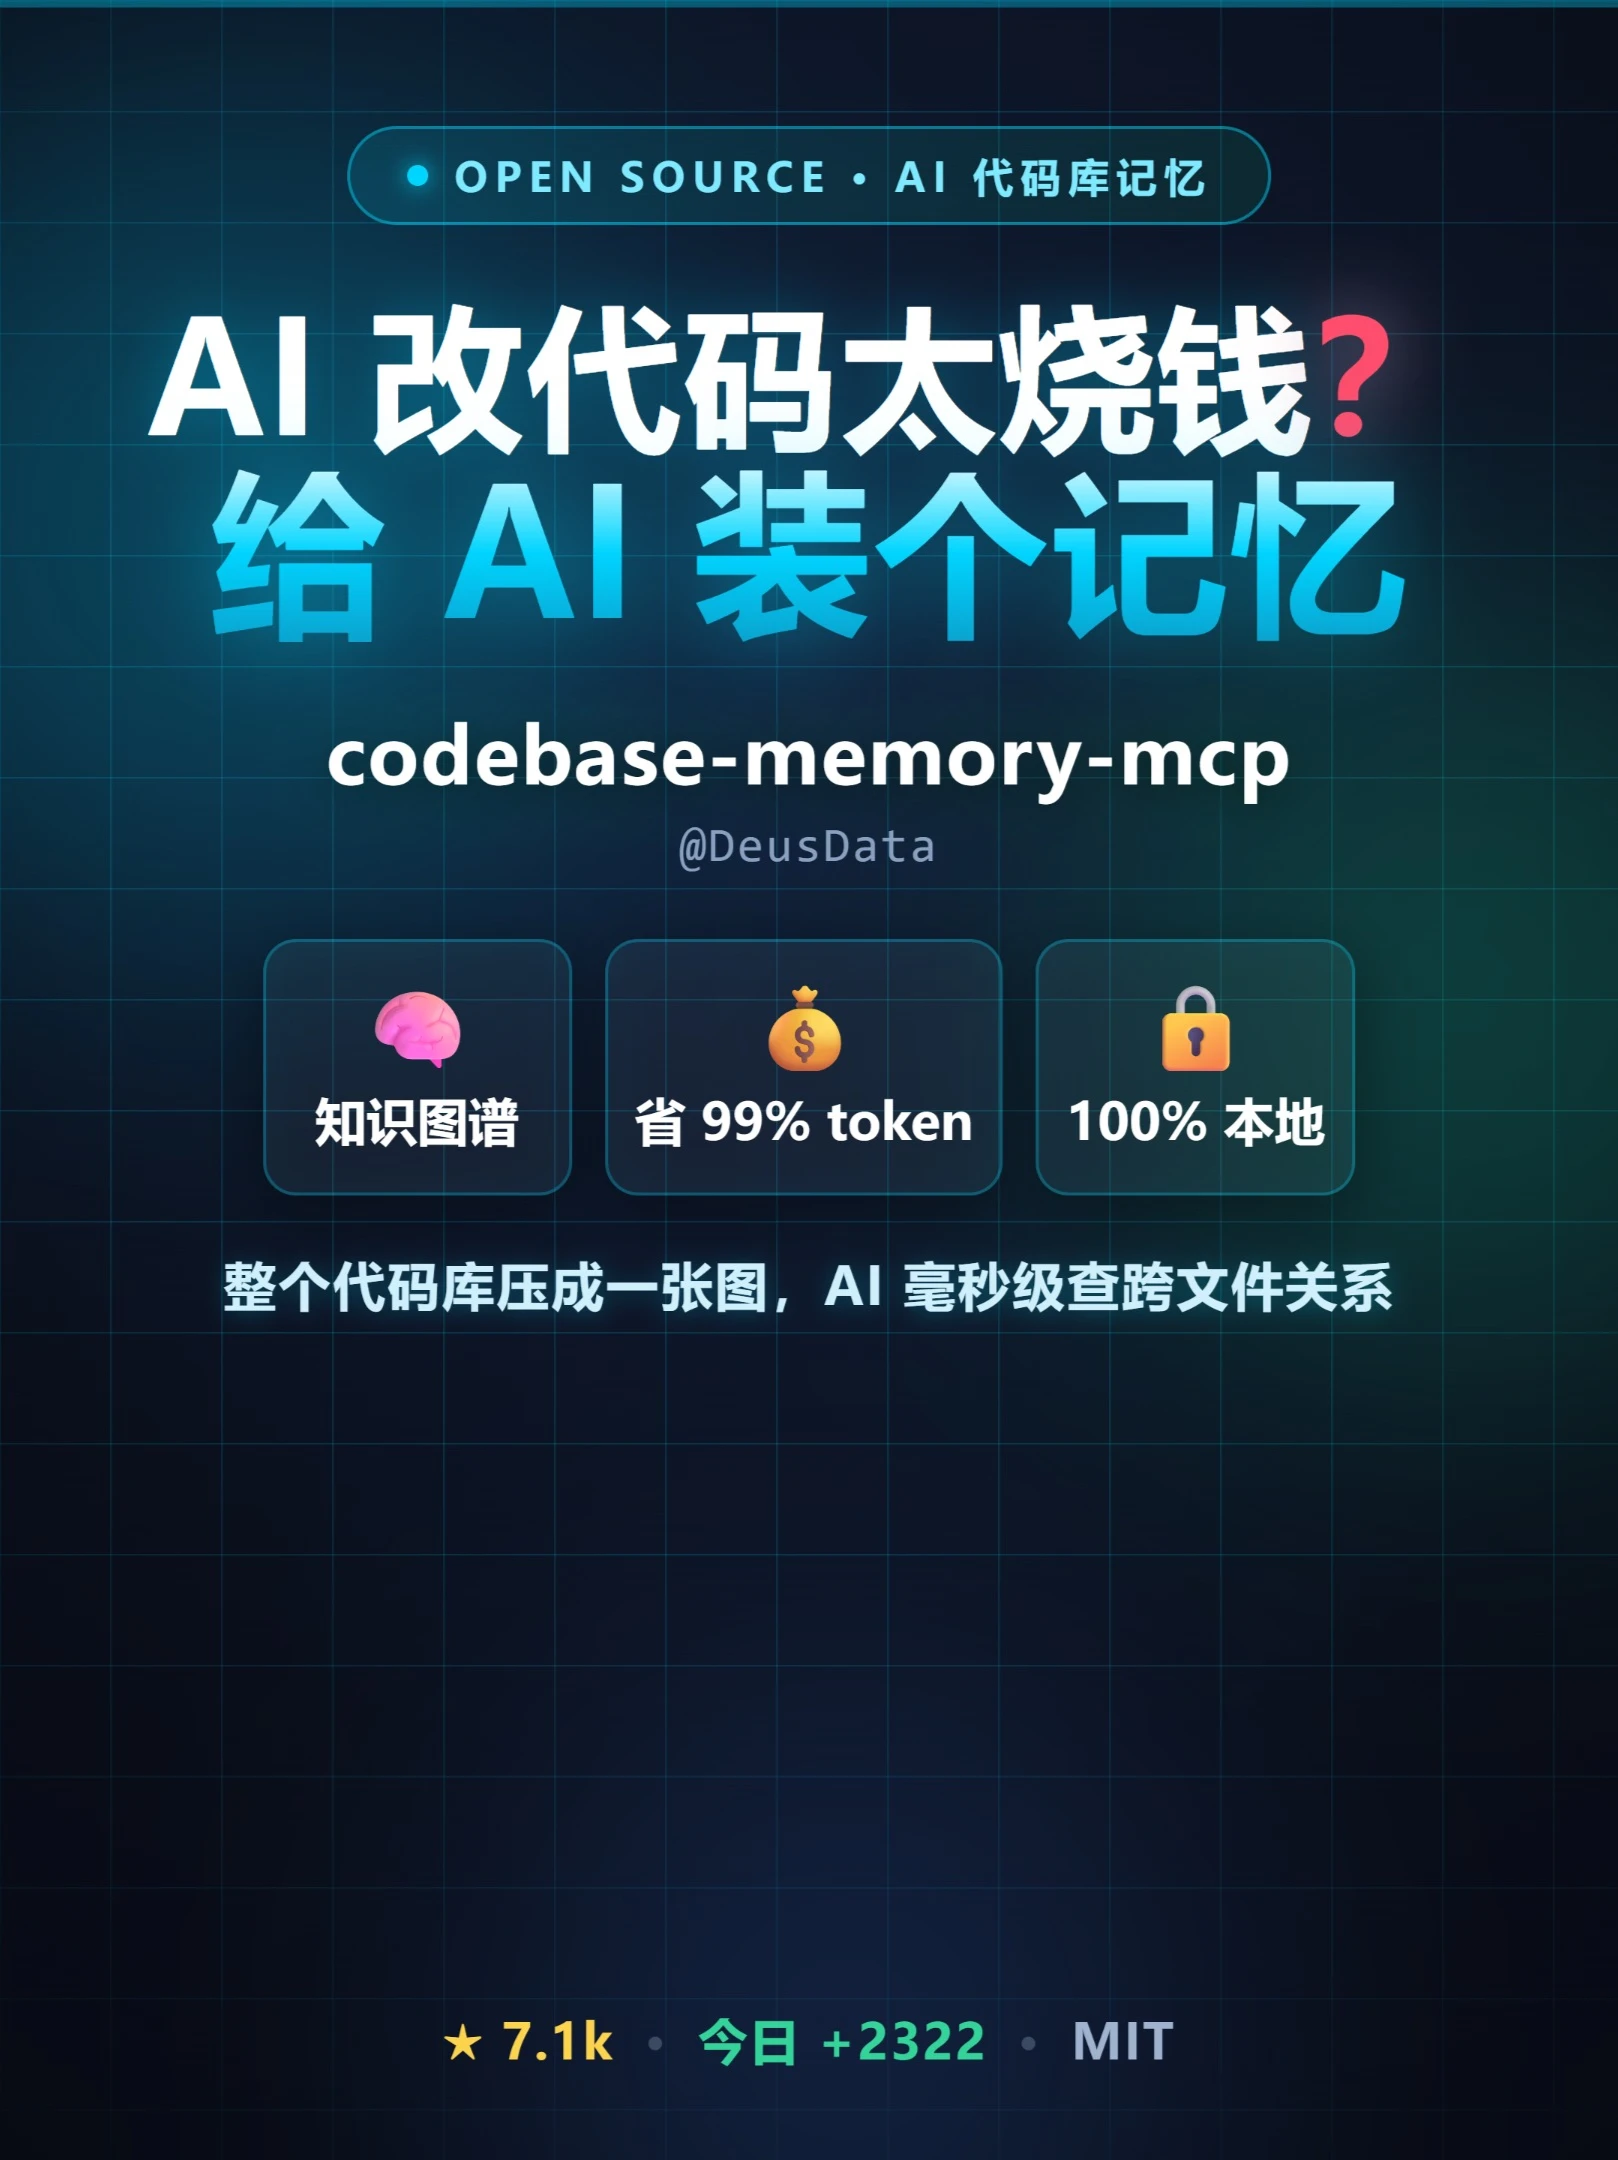
第12集:AI改代码太烧token?给它装个记忆省99%token 把整个代码库压成一张知识图谱
学会把代码库的符号与文档抽取为知识图谱/向量索引、在本地部署检索服务并接入检索增强的语言模型。可交付:本地化的代码知识图谱、向量检索接口与示例查询流程,帮助在查询时提供精确上下文,降低对长 prompt 的依赖。
图片解读
图片 1 — 逐项整理(中文)
一、可读文字(逐行、逐项精确抄录,按从上到下、从左到右排列)
- “OPEN SOURCE · AI 代码库记忆”(位于上方椭圆框内,左侧有一个青色小圆点)
- 大标题第一行: “AI 改代码太烧钱?”(问号为红色)
- 大标题第二行: “给 AI 装个记忆”
- 次级英文: “codebase-memory-mcp”
- 小字: “@DeusData”
- 三个方框内的短文本(从左到右):
- 方框一: “知识图谱”(上方为脑形图标)
- 方框二: “省 99% token”(上方为钱袋图标)
- 方框三: “100% 本地”(上方为锁形图标)
- 宣传句: “整个代码库压成一张图,AI 毫秒级查跨文件关系”
- 底部信息条(从左到右):
- 黄色星形图标 + “7.1k”
- 绿色文字 “今日 +2322”
- 灰色文字 “MIT”
二、界面步骤 / UI 元素
- 顶部标签条:椭圆形标签,包含“OPEN SOURCE · AI 代码库记忆”。
- 中央主标题区:两行大字标题(问句和建议)。
- 项目标识:英文仓库名“codebase-memory-mcp”和作者/账号“@DeusData”。
- 三个特性/功能卡片(带图标和短语),水平排列,分别表示“知识图谱”、“省 99% token”、“100% 本地”。
- 宣传说明文本,位于功能卡片下方。
- 底部状态栏/统计条:星标计数、今日新增计数、许可证(MIT)。
三、图表数据 / 可量化信息(图中可见)
- Star 数显示为“7.1k”。
- 今日新增显示为“+2322”。
- 图中声明“省 99% token”。
- 图中声明“100% 本地”。
- 显示“MIT”。
四、可见现象 / 视觉特征
- 背景为深色(近黑/深蓝)网格背景,带细线矩形网格。
- 主色调为青蓝色渐变,标题“给 AI 装个记忆”为亮青到蓝渐变,问号为红色点缀。
- 元素有发光/荧光效果(标题与图标边缘有光晕)。
- 三个功能卡片为圆角矩形并带浅色内阴影。
- 图标风格扁平、彩色(脑、钱袋、锁)。
- 布局垂直居中,信息由上到下层级清晰。
五、事实(仅列出图像中可直接读取或客观观察到的内容)
- 图片中显示文字:“AI 改代码太烧钱? 给 AI 装个记忆”。
- 显示英文标识“codebase-memory-mcp”和账号“@DeusData”。
- 三个功能卡片文本为“知识图谱”、“省 99% token”、“100% 本地”。
- 宣传句为“整个代码库压成一张图,AI 毫秒级查跨文件关系”。
- 底部显示“★ 7.1k · 今日 +2322 · MIT”。
- 背景为带网格的深色调,并使用青蓝色高亮与发光效果。
六、推测(标明为推测的内容,不作为图中直接事实)
- 推测“codebase-memory-mcp”是项目或仓库名称。
- 推测“@DeusData”是该项目的作者或发布者账号。
- 推测“MIT”表示项目采用 MIT 许可证。
- 推测三张卡片分别表示该项目的三个主要优势/特性:知识图谱化、节省 token、完全本地运行。
- 推测底部的“★ 7.1k”与“今日 +2322”为项目的 Star 总数与今日新增 Star 数。
七、无法辨认 / 模糊处
- 椭圆标签内两侧的极小文字或装饰在当前分辨率下不可读。
- 底部状态栏两侧可能有被裁切的图标或文字未完整显示。
- 若图中存在更小的注释性文字(如版权、小字说明等),在当前分辨率下无法清晰读取。
- 方框内图标下方是否有更小的副标题或说明文字无法判定。
八、忽略的内容说明
- 未对图中任意可视化控件执行操作(仅进行了视觉记录和转写)。
如需把上述各元素按层级导出为可编辑 JSON 或对某行文字做逐字放大识别,请具体指示。
SkillPI 作品解读
作品用途与图片证据摘要:
- 用途:图片展示一个开源项目或演示页(标识为“codebase-memory-mcp / @DeusData”),宣传把“整个代码库压成一张图”以便 AI 毫秒级查跨文件关系、并宣称可“省 99% token”且“100% 本地”。这些宣传性文字在图片中可直接读取(见 image_text)。
关联技能与可能的实现步骤(为便于复现的高层次说明,需后续验证具体实现):
1) 代码语义抽取:解析代码中的符号、注释、文档、依赖关系,构建实体(函数、类、模块、注释段落)和它们的关系网络。
2) 表征/向量化:对代码片段与文档生成向量表示(embedding),以支持相似度检索或链接推断。
3) 知识图谱或图/索引构建:将抽取的实体与关系组织为图结构(知识图谱)或结合向量索引(如本地向量数据库)以支持高效查询。
4) 检索层与 LLM 集成:在需要时用检索到的相关节点或上下文作为 LLM 的外部上下文(检索增强生成,RAG),从而减少对长 prompt 的依赖并缩短模型需要处理的 token 长度。
5) 本地化部署:把索引、图数据库与检索接口部署在本地或私有环境以实现“100% 本地”运行承诺。
复现前提(必须满足的要点):
- 获取完整或代表性的代码库数据(源码、文档和注释)。
- 可用的 embedding 生成能力(预训练模型或本地 embedding 服务)以及计算资源用于向量化。
- 用于存储与检索的本地后端(向量数据库或图数据库)以及用于快速查询的索引结构。
- 用于串联检索与 LLM 的中间层或微服务(实现检索结果拼接/摘要并传给 LLM)。
待核实项(图片中有声明但需查证的要点):
- “省 99% token”的具体测量方法与场景限制(哪些操作、哪类任务下的统计)。
- “100% 本地”声明是否涵盖 embedding 模型、索引构建与推理,或是否需要联网下载模型权重/外部服务。
- repository 名称“codebase-memory-mcp”与账号“@DeusData”是否对应可访问的开源项目及其源码实现。
- 使用的 embedding 模型、检索后端(向量库/图数据库)、以及索引策略(是否有去重、分段策略等)。
说明与风险提示:
- 本解读仅基于图片可见信息与常见技术路径进行合理推断,未对任何仓库代码或实现进行实际验证。若需进一步把项目完整复现或验证其性能,应获取项目源码与文档、阅读实现细节并进行实验性测试以确认 token 节省、延迟与本地运行能力。