
爆火项目 headroom 源码解析
本文可学到如何从 GitHub 获取并审查 headroom 源码:定位“context compression layer”模块、阅读实现、设计可重复基准、使用 tokenizer 计量启用/禁用压缩前后的 token 消耗,并列出复现所需的环境与待核实项,帮助验证图片中提到的“90% token”说法(不对该数值做预设)。
图片解读
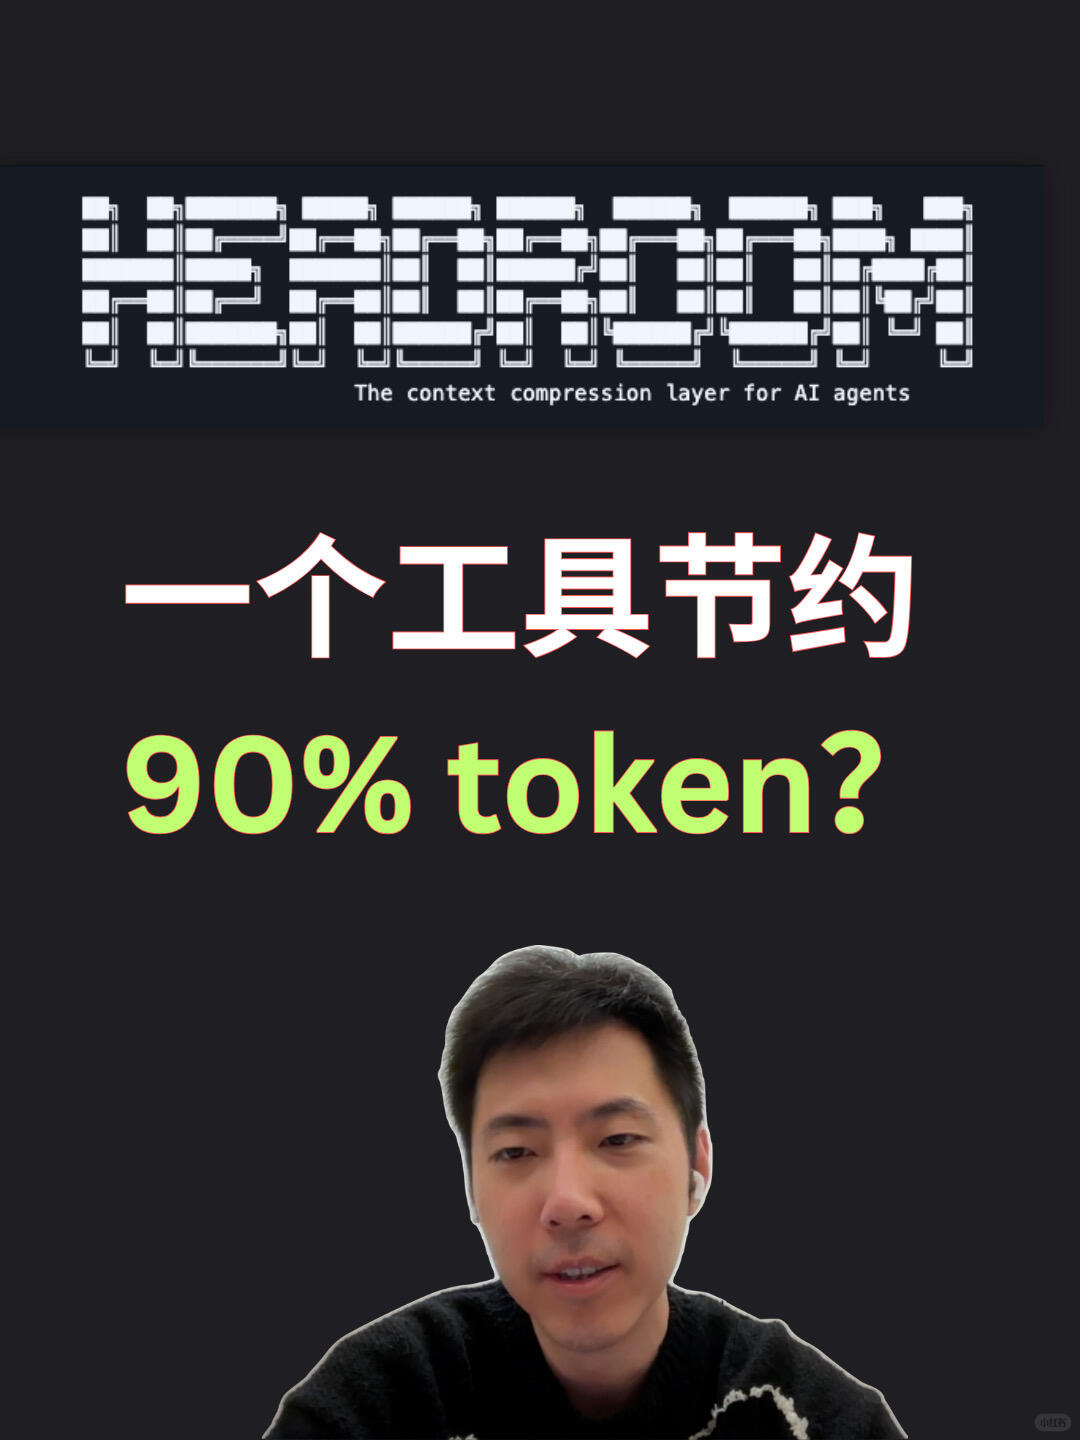
第1张 图像证据整理
一、事实(仅列出可直接读取或客观可见内容)
- 可读文字(逐行/逐块):
- 顶部 ASCII 风格图形下方有英文小字:The context compression layer for AI agents
- 中央大字(中文):一个工具节约
- 中央次大行(英中混排,绿色):90% token?
- 布局与界面元素:
- 背景为深色(近黑或深灰)。
- 顶部为一段白色的 ASCII 风格图形或徽标,位于页面最上方正中偏上。
- 中间为大号中文标题,标题下为绿色的大号英文/数字“90% token?”。
- 底部中央为一张半身人像(真人照片或截图),人物头部略居中偏下,人物上半身裁剪后置于深色背景前。
- 右下角靠近边缘有一个很小的圆形或椭圆形水印/图标(不可读)。
- 可见人物与着装(客观描述,不做身份判断):
- 一名成年人正面或略侧面的面部照片。
- 人物佩戴耳塞或耳机(右侧耳可见白色耳塞)。
- 穿着深色上衣(黑色或深灰,领口与胸前有少量浅色花纹或线条)。
- 人脸被清晰拍摄,肤色、五官可见(不在此辨识身份)。
- 颜色与样式:
- 中文标题为白色描边(内侧可能为粉色或浅色轮廓),字体较粗。
- “90% token?” 为浅绿色/荧光绿,字号大且醒目。
- 页面整体采用极简深色海报式设计。
二、推测(明确标注为推测,不作为事实)
- 顶部 ASCII 风格图形很可能是项目或产品的 logo / 名称图形化呈现,配套英文小字为该项目的副标题或说明(“The context compression layer for AI agents” 可解读为该项目功能描述)。
- 中文“大标题”可能在表达该工具可以节省“90% token”的含义(标题与下方“90% token?” 组合呈现为疑问或宣称节省比例)。
- 底部人像可能是视频会议截图、介绍者照片或用于宣传的讲者头像(因佩戴耳塞且为近景),也可能来自短视频或演讲的截帧。
- 右下角小水印/图标可能为发布平台或制作工具的标识(比如应用或社交平台 logo),但图案太小无法确认。
三、无法辨认或不确定的内容(需要原图更高分辨率或补充信息)
- 顶部 ASCII 图形中具体字母/单词的可辨识度不足,无法确定该 logo 精确拼写或含义。
- 右下角小圆形水印/图标的具体文字或符号无法辨认(过小且模糊)。
- 图像是否包含其他小字或版权信息(如作者名、发布时间等)在当前分辨率下不可见或不可读。
- 中文标题的语义完整性:图片中显示为“一个工具节约”,但这句短语在语法或上下文上可能不完整,无法确定是否有被裁切或省略的文字。
备注
- 按要求已忽略图中任何可能的“操作指令”,仅记录并区分事实与推测。
- 关于图中人物:出于隐私与安全策略,不进行身份识别或确认,仅做外观与可见物品的客观描述。
SkillPI 作品解读
作品用途
- 该素材提示 headroom 项目自称为“面向 AI 代理的上下文压缩层”(The context compression layer for AI agents),用途应为在与大模型交互时减少上下文占用,从而降低 API 调用时的 token 使用量或提升长期上下文处理能力。
图片证据说明(基于 image_text 的可见事实与推测)
- 图像中显示的项目副标题、醒目的“90% token?” 文案与深色海报式设计共同暗示该项目宣称能大幅减少 token 使用,但图片本身只提供了宣称或营销语,并未包含技术细节或测试数据。
关联 Skill 与可行的分析步骤(当前输入未提供具体 Skill,以下为通用可执行步骤,需在复现前核实是否适用)
1) 获取源码:在确认 headroom 的官方仓库地址后,克隆代码库并查看 README、CHANGELOG、示例和文档目录。
2) 定位核心模块:搜索仓库中与“compress”、“context”、“token”、“encoder”、“summarize”、“embedding”、“buffer”等关键词相关的文件,查找提到“context compression layer”的模块或注释。
3) 阅读实现与注释:逐文件阅读核心实现,记录关键函数、数据流、输入/输出格式及外部依赖(如向量数据库、embedder、序列化方法)。
4) 运行示例/测试:如仓库包含示例脚本或测试用例,按说明运行以观察默认行为;若无,按照 README 指南构造最小可运行示例。
5) 计量 token 使用:使用已知的 tokenizer 库或工具(例如模型对应的 tokenizer)统计在启用/不启用 headroom 压缩前后的 token 数量。确保在相同提示和上下文下对比。
6) 基准测试:设计可重复的 benchmark(固定输入集、多次运行取均值)来评估压缩前后对 token 消耗、延迟与输出语义保真度的影响。
7) 分析压缩策略:从源码判断是否使用了摘要(summarization)、检索增强(RAG)、向量索引、增量上下文、增量摘要或自定义编码器,并记录这些策略对 token 数量与上下文完整性的权衡。
复现前提
- 能访问并克隆 headroom 官方仓库(确认仓库 URL 与版本);
- 具备运行代码所需的运行时与依赖(Python/Node 等环境、依赖包、可能需要的模型或外部服务);
- 用于计量 token 的 tokenizer 或工具,以及被测试的大模型(本地或 API 接口)和相同的 prompt 数据集;
- 基准用例与评估标准(用于衡量压缩后输出是否保持必要信息)。
待核实项(不可在当前素材下断言)
- “节约 90% 的 token”是否为在特定场景或数据集下的实验结果、平均值、极端值还是营销宣称;
- 具体采用的压缩算法或技术细节(图片与摘要未提供实现代码或算法描述);
- 是否存在预训练组件、外部付费服务或专有模型影响了测评结果。
备注与风险提示
- 图像与摘要提供的是宣传性表述与视觉证据,无法替代对源码的直接审查与独立基准测试;
- 在没有直接运行并测量的前提下,不应把“90%”作为普适或已验证的效果来引用;
- 如果需要进一步帮助,可提供 headroom 仓库链接或允许我生成具体的检索/基准脚本样例(会基于公开常用工具与方法,而非未核实的内部实现)。