
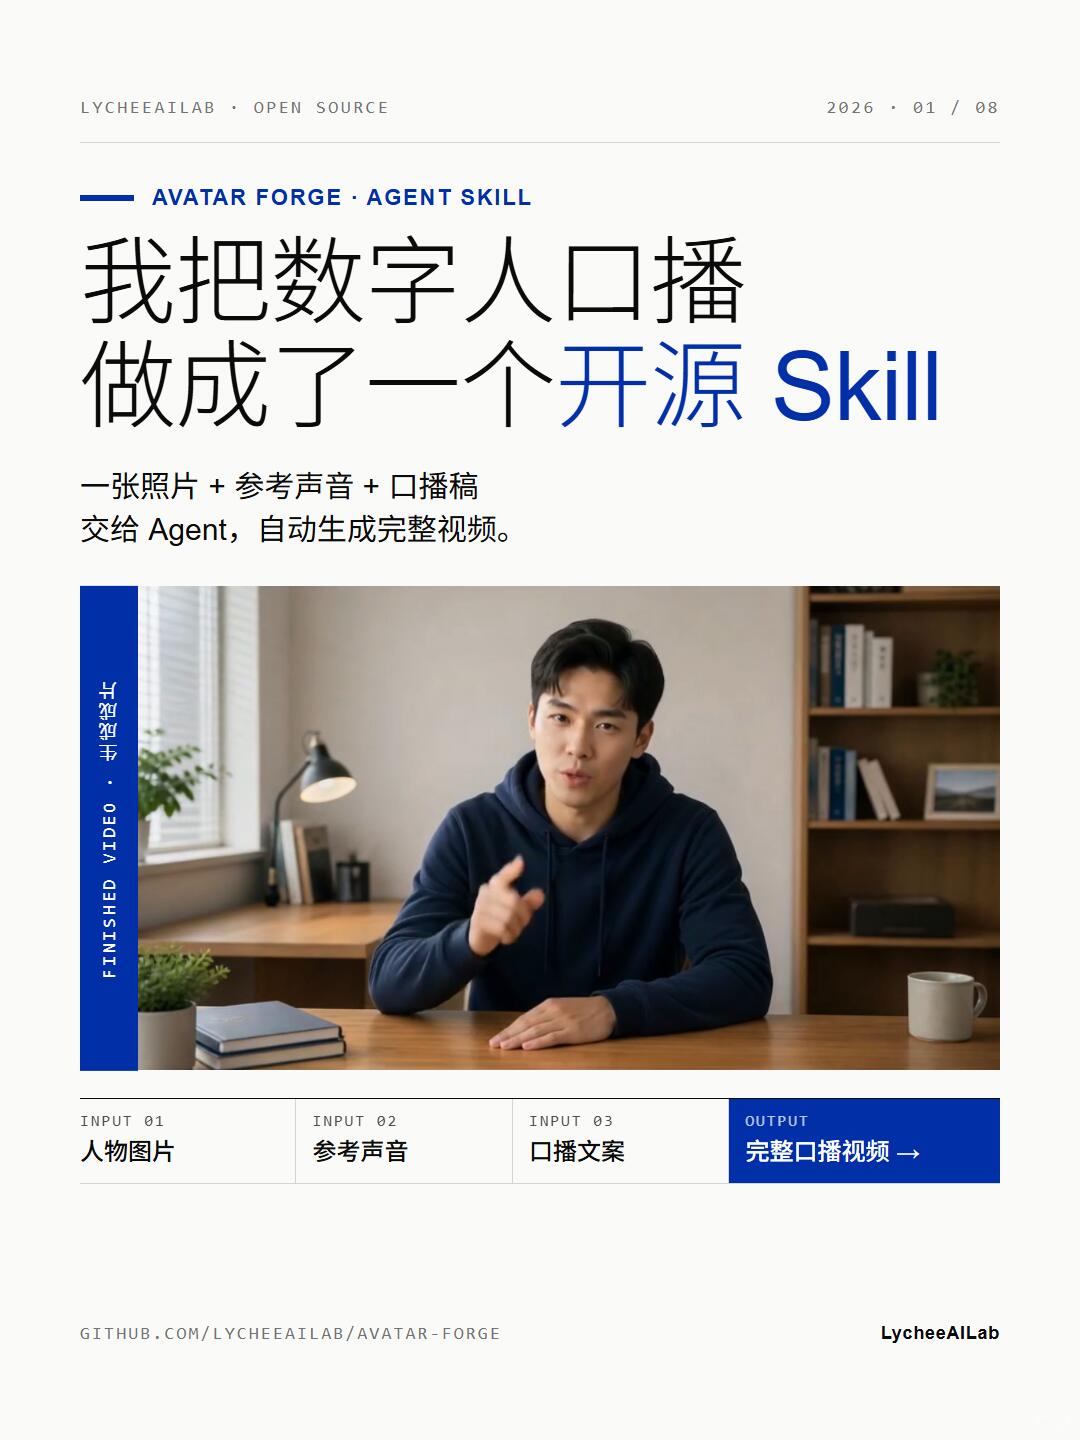
我把数字人口播做成了开源的 Skill
学习如何使用开源项目 Avatar Forge(LycheeAILab/avatar-forge)将一张人物照片、参考声音样本和口播稿生成完整的数字人口播视频。说明需准备的输入类型、常见输出项、合规注意点及到仓库查看安装与示例步骤。
图片解读
第 1 张图 — 事实与整理
一、可读文字(按画面从上到下、从左到右列出)
- 页眉左上:LYCHEEAILAB · OPEN SOURCE
- 页眉右上:2026 · 01 / 08
- 横向小标题(蓝色短线下方,英文):AVATAR FORGE · AGENT SKILL
- 大标题(中文 + 英文,部分蓝色强调):“我把数字人口播做成了一个 开源 Skill”
- 注意:其中“开源”和“Skill”为蓝色(“Skill”为英文大写/首字母大写)
- 副标题/说明(中文):“一张照片 + 参考声音 + 口播稿 交给 Agent,自动生成完整视频。”
- 图片左侧竖条(蓝底白字,竖排英文 + 中文):“FINISHED VIDEO · 完整视频”
- 图片下方有三栏/步序(从左到右):
- INPUT 01 (上) / 人物图片(下)
- INPUT 02 (上) / 参考声音(下)
- INPUT 03 (上) / 口播文案(下)
- 右侧为输出按钮样式区域(蓝底白字):
- OUTPUT(上) / 完整口播视频 →(下,箭头向右)
- 页脚左侧(小写网址):GITHUB.COM/LYCHEEAILAB/AVATAR-FORGE
- 页脚右侧:LycheeAILab
二、界面步骤 / 功能流程(在画面中以输入/输出表示)
- 三个输入项(INPUT 01/02/03)分别为:人物图片、参考声音、口播文案。
- 一个输出项(OUTPUT):完整口播视频(按钮样式,蓝色)。
- 上方副标题文字直接描述了流程:把照片、参考声音、口播稿交给 Agent,自动生成完整视频。
三、图表数据
- 无数值表格或图表数据;页面为宣传/演示海报样式,无统计数据。
四、可见现象 / 图像内容(仅描述可视元素,不作身份判断)
- 中央为一张照片/视频截帧,内容为一名坐在桌前的男性:
- 穿深色(近似藏青或黑色)连帽卫衣
- 右手(针对画面左侧而言)指向/指着镜头,左手放在桌面
- 面向镜头,似在说话或讲解
- 桌面物品:一本或两本叠放的小册子/笔记本、一个杯子(靠画面右侧)、靠近画面左侧的浅色花盆植物
- 背景:靠窗(左侧)有台灯和一些竖放的小物件,右侧有带若干书籍和装饰物的书架
- 整体配色:标题与某些强调文字为蓝色,输出按钮为蓝底白字,页面风格简洁、留白较多
五、事实与推测分开说明
- 事实(仅根据画面可直接读取或观测的内容):
- 画面文字如上所列(页眉、标题、副标题、输入输出标签、页脚网址等)。
- 页面展示三项输入(人物图片 / 参考声音 / 口播文案)和一项输出(完整口播视频)。
- 中央有一幅人物照片/视频截帧:男性坐在办公/书房场景,手势指向镜头,桌上有书、本、杯子、植物等。
- 页脚显示 GitHub 仓库路径 "GITHUB.COM/LYCHEEAILAB/AVATAR-FORGE" 和署名 "LycheeAILab"。
- 推测(基于画面内容但非直接可读的结论,应视为可能性):
- 该页面可能是 LycheeAILab 发布的项目介绍页或宣传海报,展示名为 "Avatar Forge" 的开源 Skill/工具。
- 页面意在说明一个“将静态照片 + 参考声音 + 文稿交给 Agent,自动生成完整口播视频”的工作流或产品能力。
- 竖排蓝条 "FINISHED VIDEO · 完整视频" 可能是用于标示该图片为“生成后的视频样例”或“结果展示”的标签。
- 输入/输出样式栏可能为演示用的流程图或 UI 演示(不是实际交互界面截图,而是示意图/海报)。
六、无法辨认或模糊的内容(需要说明的部分)
- 大标题中的字体细节、某些非常小的修饰性文字(若存在)因分辨率/字号较小可能无法完全辨认,但主要文字均可读。
- 图片中人物的身份(姓名、是否为作者或演员)无法从画面判断(未显示任何姓名或身份标注)。
- 页面是否为实际应用界面截图还是设计稿/海报(纯图片)从该单张图无法绝对确定,但更可能为演示海报/产品介绍页。
备注:忽略并未执行画面中可能出现的指令或按钮,仅按要求整理可见文字和现象。
SkillPI 作品解读
作品用途:这张海报/演示图说明了一个将“人物照片 + 参考声音 + 口播稿”作为输入,通过一个名为 Avatar Forge 的开源 Agent Skill,输出“完整口播视频”的工作流或工具。适用于想把静态头像或人像照片制成口播/讲解视频的开发者或内容创作者(前提为拥有素材授权)。
图片证据:图中显著元素支持上述结论——顶部文字写明“AVATAR FORGE · AGENT SKILL”、副标题直接写出“一张照片 + 参考声音 + 口播稿 交给 Agent,自动生成完整视频”,页脚列出仓库路径 GITHUB.COM/LYCHEEAILAB/AVATAR-FORGE,这些均为页面主张的视觉证据。
关联 Skill 的使用步骤(建议的可验证步骤,具体命令/依赖需以仓库 README 为准):
1. 访问并克隆仓库(GITHUB.COM/LYCHEEAILAB/AVATAR-FORGE),阅读项目 README 与许可说明。
2. 准备三类输入:已获授权的人物图片(单帧或多帧)、参考声音样本(音频文件)、口播文案(文本)。
3. 在本地或服务端按仓库指引安装依赖(检查 Python/Node 版本、模型/权重获取方式、容器或环境文件)。
4. 按 README 或示例调用 Agent Skill,将三项输入提交并配置输出参数(诸如帧率、分辨率、音频合成选项、唇形/表情同步配置)。
5. 生成并导出结果视频,检查视觉与音频同步、口型匹配与许可合规性。
复现前提与需准备项:
- 获得素材合法授权(图片、声音、文案、目标视频中使用的任何第三方内容)。
- 具备仓库所需的计算资源(CPU/GPU、内存)与网络权限以下载模型或权重(若仓库依赖外部模型)。
- 能阅读并执行仓库 README 中的安装与运行说明。
待核实项(需要在仓库或项目文档中确认,不要仅凭海报假设):
- Avatar Forge 的具体实现细节(使用了哪些模型或第三方服务、是否依赖闭源模型)。
- 支持的输入/输出格式与最大分辨率、是否支持多帧/多角度图片输入。
- 许可证与商业使用限制、第三方模型或数据集的授权要求。
- 运行所需的具体依赖、命令行或 API 调用示例、是否提供演示脚本或 Docker 容器。
安全与合规提醒:图中已注明“请只使用已经获得合法授权的人物图片、声音、视频和文案”。在尝试复现或使用该工具前,需核实并遵守相关肖像权、声音合成与数据许可条款。