
PDF 转 RAG 结构化数据,本地使用 OpenDataLoader PDF(CPU 可运行)
学习在本地使用 OpenDataLoader PDF(Apache-2.0)将 PDF 转换为 Markdown/HTML/结构化 JSON,并保留页码与 bounding boxes,恢复多栏阅读顺序、提取表格与图片,遇扫描件时启用 Hybrid OCR。文中说明可用的 Python、Node.js、Java 与 LangChain 接口,适合集成到 RAG/知识库管道的处理步骤与复现前提。
图片解读
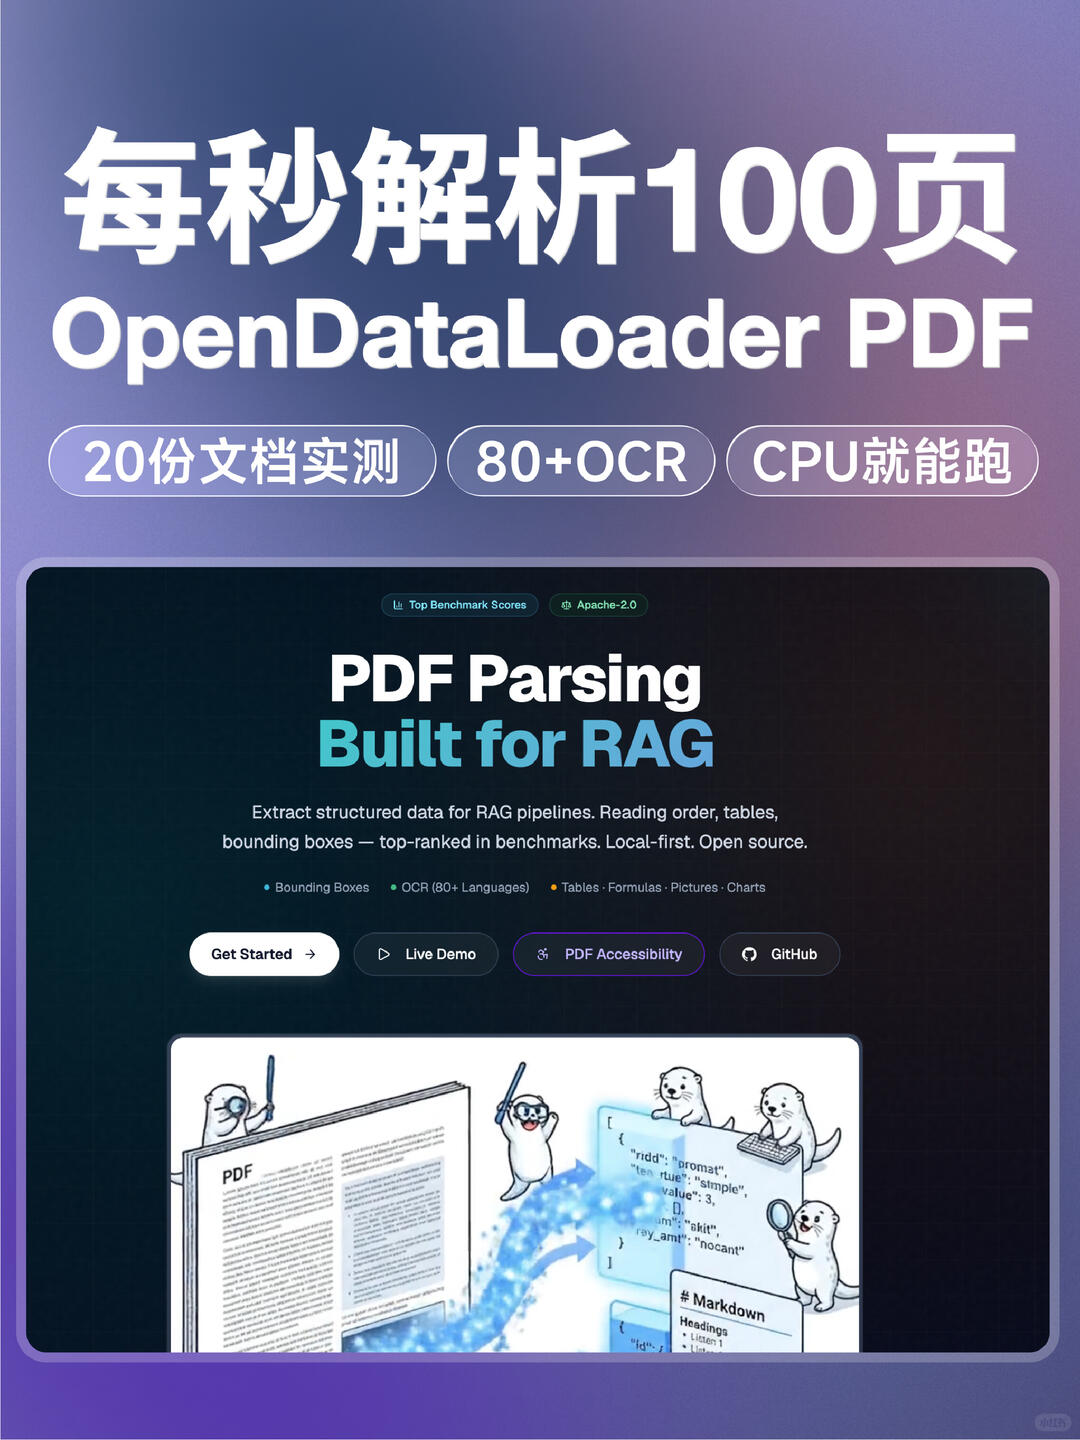
第 1 张图片 — 事实与可见证据(按画面从上到下、从左到右整理)
事实(可直接读出的文字、界面元素、图表数据和可见现象)
- 页面顶部大字(中文):每秒解析100页
- 英文标题:OpenDataLoader PDF
- 三个圆角标签(横排):
- 左:20份文档实测
- 中:80+OCR
- 右:CPU就能跑
- 页面主体区域顶部有两个小徽章 / 标签(英文):
- Top Benchmark Scores
- Apache-2.0
- 主标题(英文,大字):PDF Parsing
- 副标题(英文,大字,蓝色字):Built for RAG
- 主说明段落(英文,可读部分):
- "Extract structured data for RAG pipelines. Reading order, tables, bounding boxes — top-ranked in benchmarks. Local-first. Open source."
- 屏幕下方有若干要点(点状列举,英文,部分可读):
- Bounding Boxes
- OCR (80+ Languages)
- Tables · Formulas · Pictures · Charts
- 三个主要交互按钮(英文):
- Get Started →
- Live Demo ▶
- PDF Accessibility
- 另有 GitHub 按钮(带 GitHub 图标)
- 页面中部偏下有一幅插画:展示一本标注为 “PDF” 的书/文件,右侧有代码/数据块(像 JSON 或结构化文本),几只拟人化的水獭/海獭形象在围观/操作
- 插画中可读文字:
- 在代码/数据块附近部分可见“# Markdown”标题
- 在展示的“代码/数据”内有若干看起来像键/值的词(词形不全或部分可辨)
- 页面整体配色:渐变紫/蓝背景,主体内容区为深色(接近黑或深蓝),文字以白色和亮蓝色为主
- 页面四周有圆角边框(紫色或带阴影的容器样式)
- 图片右下角有一个小圆形印记(非常小,难以辨认具体文字或图案)
无法辨认或不确定的具体文字
- 插画中代码/数据块内的具体字段和值仅部分可辨,怀疑包含类似 "ridd", "promat", "value", "sample", "pay_amt" 等字母组合,但这些词拼写和完整性不确定
- 页面最下方插画右侧或角落处的小文本和细小图标(太小模糊,无法读取具体内容)
- 右下角小圆形印记的文字或图标无法辨认
推测(基于画面元素的合理推断)
- 该图片为产品/项目的宣传页或首页截屏,介绍一个名为 OpenDataLoader PDF 的工具或库,侧重 PDF 解析并面向 RAG(Retrieval-Augmented Generation)流程
- “每秒解析100页”、“20份文档实测”、“80+OCR”、“CPU就能跑” 等为性能与能力宣称或卖点
- 页面上的按钮(Get Started、Live Demo、PDF Accessibility、GitHub)可能分别链接到快速开始文档、在线演示、无障碍信息页和代码仓库
- 插画意在表示将 PDF 内容转换成结构化数据(如 JSON 或 Markdown),并且有对表格、公式、图片和图表的支持
- “Top Benchmark Scores”和“Apache-2.0” 表明该项目宣称在基准测试中表现良好且采用 Apache-2.0 开源许可证
SkillPI 作品解读
用途:
- 该资料介绍 OpenDataLoader PDF,一款用于将 PDF 转为 RAG/知识库可用的结构化数据(Markdown、HTML、结构化 JSON)的本地解析引擎。适用于需要保留页码与坐标以便精准切块、检索与原文高亮引用的场景。
图片证据要点(可验证的视觉信息):
- 页面以“OpenDataLoader PDF”为名,强调 PDF Parsing、Built for RAG、Bounding Boxes、OCR (80+ Languages)、Tables、Formulas、Pictures、Charts 等功能;存在 Apache-2.0 徽章与“Top Benchmark Scores”文案;并宣称“每秒解析100页”“CPU就能跑”等卖点(这些为页面上的可见文案,但为宣称需验证)。
关联 Skill 与可行步骤(基于来源中列出的接口与能力,供复现参考而非保证复现结果):
1) 准备环境
- 在本地获取 OpenDataLoader PDF 项目源代码或发布包(项目以 Apache-2.0 开源)。
- 根据项目文档选择语言接口:Python、Node.js 或 Java;若要在 RAG 管道中使用,可查看 LangChain 接口说明。
2) 基本 PDF 解析(电子 PDF)
- 使用项目提供的命令或 SDK 将 PDF 转换为目标格式(Markdown/HTML/JSON),启用保留页码与 bounding boxes 的选项以便后续精确引用与切块。
- 验证多栏阅读顺序是否被正确恢复(针对多栏排版测试示例文档)。
3) 批量与无 GPU 场景
- 在仅 CPU 的机器上运行解析流程(来源宣称支持 CPU 模式),通过小批量测试评估吞吐与资源占用。
4) 扫描件与复杂元素(Hybrid 模式)
- 对扫描件或含复杂表格/公式的 PDF,启用 Hybrid 模式以结合 OCR 与可配置的 AI 后端提升识别质量(需按项目说明配置本地 OCR 引擎或选择支持的识别后端)。
5) 集成到 RAG 管道
- 使用 LangChain(若项目提供适配器)或自行实现的分块逻辑,按页码与坐标将结构化输出切成向量索引的文档片段;在检索时可用原文高亮坐标映射回源 PDF。
复现前提:
- 需要可访问的 OpenDataLoader PDF 源代码或发行版及其文档。文中提到的接口(Python、Node.js、Java、LangChain)需在项目文档中证实并按指引安装配置。
- 若要处理扫描件/复杂表格/公式,需配置并可本地运行的 OCR(或其它 AI 后端),并注意许可证与资源需求。
- 性能(如 '每秒解析100页')受硬件、PDF 内容复杂度、并发设置与版本等影响,需在目标环境中验证。
待核实项与风险提示:
- 页面宣称的性能数据(例如“每秒解析100页”、“Top Benchmark Scores”、“20份文档实测”)为页面可见宣称,未在此资料中提供独立基准细节,需在本地或查看官方基准文档验证。
- 插画与部分文本(如示例 JSON 字段)模糊且不可完全辨认,不能作为精确 API 或字段名来源。
- 若需企业级批量处理或受限于合规/数据安全要求,请验证本地部署细节、日志保存与隐私合规性。
- 若项目后续作者或分支改动其接口与功能,相关步骤需按最新官方文档调整。
总结建议:
- 将本资料作为寻找可本地化、支持结构化输出与坐标保留的 PDF 解析工具的参考线索。要进行实际集成,请先获取 OpenDataLoader PDF 的官方文档和示例代码,按环境验证功能(尤其是多栏顺序恢复、表格解析与坐标映射)与性能数据。