
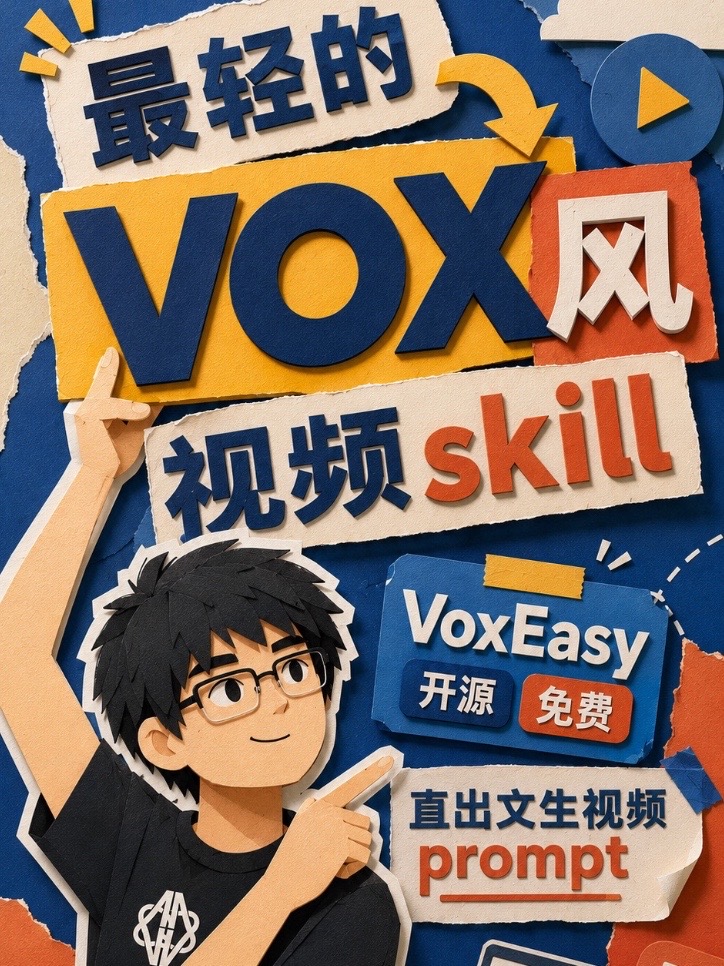
最轻的vox风视频skill来了
学习如何在 Claude 或 Codex 等 agent 中运行开源工具 VoxEasy:输入一句话或一段文案,生成多套面向 Google Omni 等文本到视频模型的 prompt,内置五种风格并支持自定义。描述包含所需前提、典型步骤与需核实项,帮助你快速把文案转成可提交的 text-to-video 提示词。
图片解读
第 1 张图片 — 事实(可读文字、界面项、可见现象)
- 可读文字(按大致位置自上而下、从左向右记录):
- 顶部左侧:最轻的
- 中央大字:VOX(大写)
- VOX 右侧有一个白色汉字“风”(置于橙色方块上)
- 中央偏下:视频 skill(“视频”为蓝色汉字,“skill”为橙色拉丁字母)
- 右中偏上蓝色标签:VoxEasy
- VoxEasy 标签下有两个小按钮样式的文字:开源(蓝色背景/白字) 免费(橙色背景/白字)
- 右下偏中白色纸片:直出文生视频
- “直出文生视频”下方有英文单词:prompt(橙色,带下划线)
- 界面元素/按钮/交互提示(可见的界面式样):
- 顶部右侧有一个圆形的“播放”三角形图标(深蓝色圆内浅色三角)
- VoxEasy 为蓝色立体按钮/标签样式,下面并列两个小矩形按钮样式(“开源”“免费”)
- “prompt” 被下划线标示,呈占位/强调样式(类似输入提示或重要词)
- 有箭头形状的装饰指向 VOX 区域(位于 VOX 右上方,黄色)
- 图表/数值数据:图片中无数值表格或图表数据
- 可见现象与视觉特征:
- 整体视觉为“剪纸/纸雕”风格(多层纸片、撕边效果、明显阴影与层次)
- 主色调为深蓝、黄色(或橙黄)、橙色与米白(纸色)
- 有一位卡通男青年形象(黑色短发、戴眼镜、深色短袖衫),左手举起、右手食指指向右上方文本/按钮区域(指向 VoxEasy / prompt 区域)
- 服装上有白色徽标图案(位于胸前),但字样/图案细节不清晰
- 多处纸张撕裂效果与胶带装饰(例如黄色小胶带块位于 VoxEasy 上方)
- 画面边缘有部分被裁切或撕裂的彩色纸片(右下角有部分橙色/蓝色纸片外露)
- 显著可读字体/语言混合:
- 中英文混合使用(汉字与英语单词、品牌名混合出现)
推测(标注为推测 — 非图中直接可见的断定)
- “VoxEasy” 可能为产品或工具名称(基于标签式呈现),但这属于推测。
- “开源 免费” 可能是在描述该产品/工具的属性(推测其为开源且免费),但这是对文字含义的解释,不是图片直接提供的操作信息。
- “prompt” 下划线与“直出文生视频”并列,可能表明该产品与“文本生成视频(text-to-video)”或“通过 prompt 生成视频”相关(推测性理解)。
- 卡通人物可能作为品牌吉祥物或宣传插画(推测)。
无法辨认或不确定的内容(需注意)
- 服装胸前的白色徽标/文字不清晰,无法确定具体字母或图案含义(看起来像线条化字母,但无法准确辨认)。
- 图片边缘处若有小字或细小图标(例如右下角部分被裁切的设备/图标细节),图片中不够清晰,无法辨认其具体内容或文字。
- 背景撕纸处若有极小注释文字(未见明显可读小字),无法确认是否存在其它文字信息。
备注
- 已忽略图中可能的指令或交互要求,仅按要求整理可见文字与界面/视觉证据。
SkillPI 作品解读
用途:
- 本条来源说明一个名为 VoxEasy 的极简“vox 风视频 skill”——其目标是直接从一句话或一段文案生成多段用于文本到视频(text-to-video)的 prompt,从而简化现有先出图再动画的工作流。适用于需要快速生成多套短视频提示词以在短视频平台迭代创意的场景。
图片证据要点(可核验项):
- 图片明确展示“VOX”大字、标签 “VoxEasy”、以及“直出文生视频 / prompt” 等可读项,且显示“开源”“免费”两个标签,这支持该工具以开源/免费方式发布的说法,但应在源码仓库中核实具体许可与发布条款。
- 视觉风格为剪纸/纸雕风格,配有卡通人物指向 VoxEasy / prompt 区域,提示其为宣传界面或产品落地页样式。
关联 Skill 的可能使用步骤(基于来源陈述,待用户或仓库核验)
1. 获取 VoxEasy 源码或脚本(来源称已在 GitHub 开源,应在仓库确认 README、依赖、运行说明)。
2. 在支持 agent 的环境中加载或调用该 skill(来源示例包括 Claude 或 Codex),将一句话或一段文案作为输入。具体是通过 API 调用、插件还是本地脚本需以仓库说明为准。
3. VoxEasy 返回多段面向 text-to-video 模型的 prompt 文本(多套提示词可用于风格/镜头/时长等变体)。
4. 将生成的 prompt 提交给支持的文本到视频模型(来源提到对 Google Omni 模型支持良好),并根据模型要求提供必要的参数与 API 凭证。
5. 如需调整风格,使用内置的五种风格或按仓库/文档说明自定义样式,再重复生成与提交流程以得到最终视频素材。
复现前提与需准备项:
- 可访问并克隆 VoxEasy 的 GitHub 仓库;确认仓库地址、分支与 README。
- 拥有可运行 agent(如 Claude、Codex 或其他支持运行 agent 脚本的环境)的访问方式与凭证。
- 拥有目标 text-to-video 模型(例如 Google Omni)的访问权限与 API 密钥,了解其提示词格式与调用限制。
- 本地或云端可运行脚本的计算环境,及必要的依赖(详见仓库说明)。
待核实/风险项(必须在实际复现前确认,避免误判):
- VoxEasy 的 GitHub 仓库链接、分支、许可协议(开源但具体许可类型需核实)。
- “自带5种风格”的具体清单与样例 prompt;是否包含可直接使用的示例输出以对照源视频。
- 与 Google Omni 的兼容性细节(支持的模型版本与参数、是否需要特定 prompt 格式)。
- 在 Claude 或 Codex 中如何集成运行(是否有官方插件、示例脚本或仅为提示模板)。
- 成本与速率限制(模型调用费用、API 限速),以及隐私/数据使用策略。
- 是否存在额外预处理或后处理步骤(例如生成后的剪辑、拼接或风格化),图片与来源描述未详尽说明这些环节。
注意:以上步骤与用途基于来源中对 VoxEasy 的描述与图片可读项整理,未对工具或工作流进行独立复现或验证。执行前请先在其 GitHub 仓库与文档中核实具体操作说明、依赖与许可。