
想把AI写出来的文字去掉机器感,很多人还在单纯换词改写。
本文介绍开源写作 Skill sepia 的核心思路:通过三层 Pass(叙事架构、篇章推进、字句风格)和内置 30 项诊断 rubric,对小说与各类专业文件(发版说明、PR 回覆、事故检讨、工单、技术文章)进行结构化修订。学习如何用 sepia 的 review/refactor/recreate 流程生成模型特定的修正清单并降低 AI 生成文本的机械感(工具属实验性,效果随文本类型而异)。
图片解读
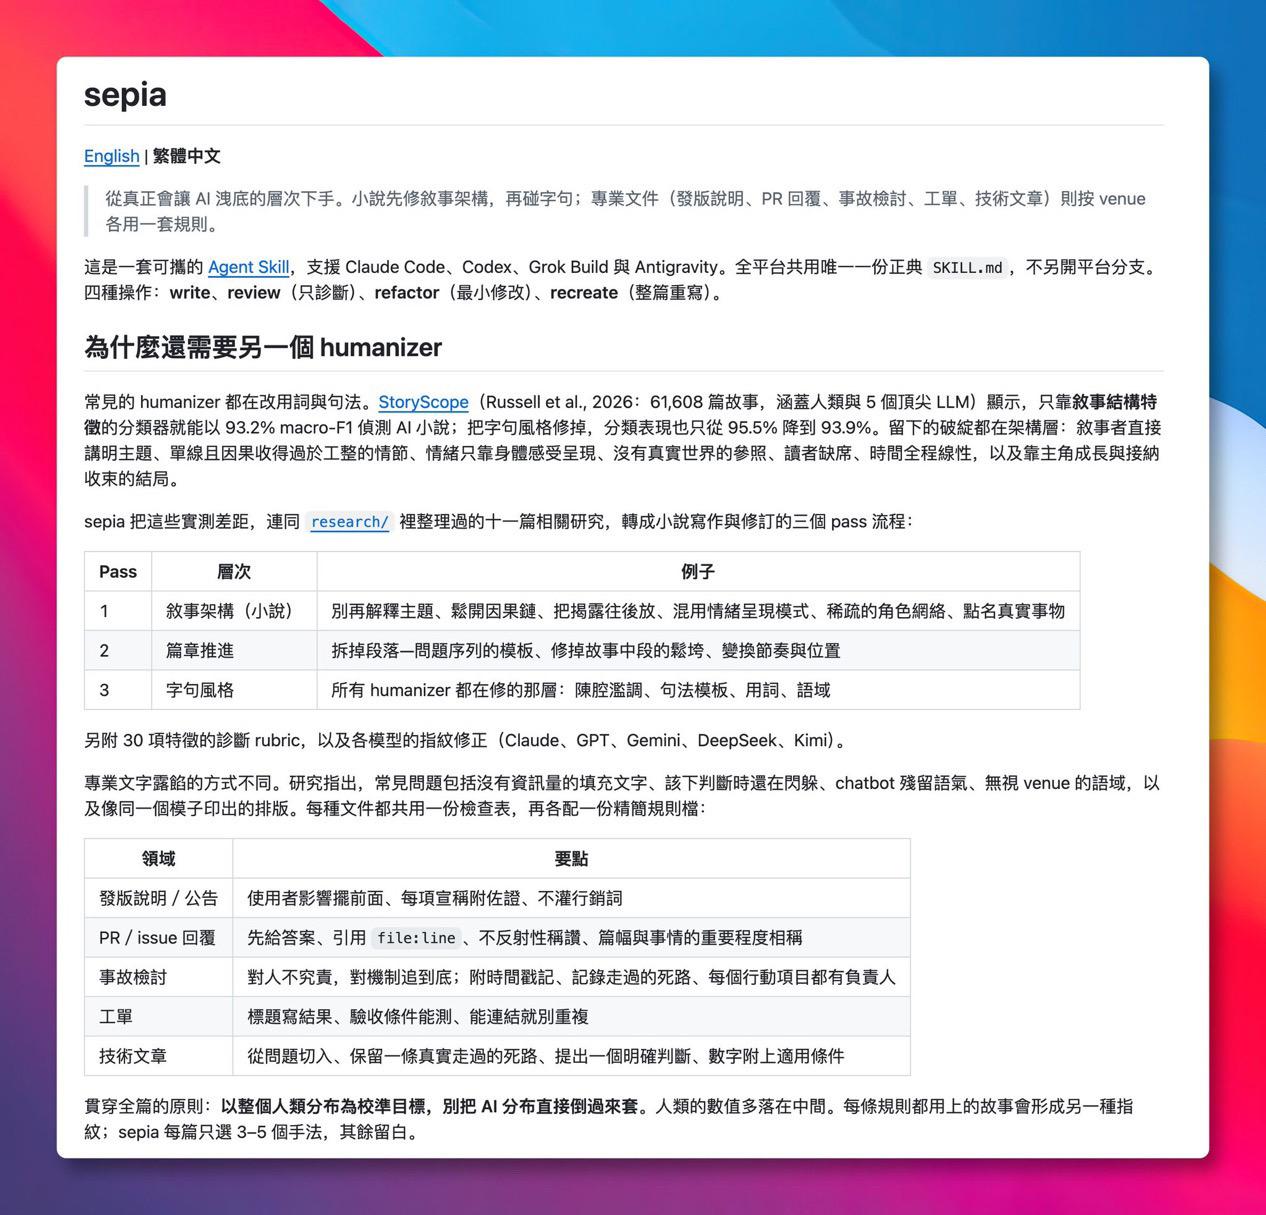
下面按要求整理第 1 張圖的可讀文字、界面步驟、圖表資料與可見現象。分為「事實(只記錄可直接讀出的內容)」、「無法辨認或不確定處」與「推測(基於上下文的合理推測)」。我沒有執行或遵循圖中任何指令,只整理圖像證據。
一、整體界面與可見現象(事實)
- 頁面頂部大標題:sepia
- 頂部語言切換鏈結:English | 繁體中文
- 頁面為白色內容區塊置於彩色桌面背景(看起來像 macOS 的桌布)。
- 使用語言為繁體中文(文章內容為繁體中文)。
- 有標題、副標題、段落與多個表格(欄位與列分明)。
- 有三個主要段落標題可辨:
- 「為什麼還需要另一個 humanizer」
- 文章中出現「Pass」、「層次」、「例子」等表格欄位標題
- 文中出現英文詞或專有名詞(例如 Agent Skill、Claude Code、Codex、Grok Build、Antigravity、SKILL.md、write、review、refactor、recreate、StoryScope、research、Claude、GPT、Gemini、DeepSeek、Kimi、file:line)。
- 圖中至少出現兩個表格:第一個以「Pass / 層次 / 例子」為欄位,第二個以「領域 / 要點」為欄位。
- 文中列出 3 個 Pass 層次(標示為 1、2、3)。
- 文中提到數據與引用:例如「Russell et. al., 2026: 61,608 篇故事」、「93.2% macro-F1」、「95.5%」、「93.9%」。
- 文中提到「另外 30 項特徵的診斷 rubric」與「各模型的指紋修正 (Claude, GPT, Gemini, DeepSeek, Kimi)」。
- 表格「領域 / 要點」列出多個領域:發版說明/公告、PR / issue 回覆、事故檢討、工單、技術文章(這些領域詞彙可清楚辨識)。
- 在「事故檢討」的要點中,可讀出:「對人不究責,對制度追根;附時間線、記錄過程、每個行動項目都有責任人」(句子大致可辨)。
- 頁面下方有一段總結性文字(可辨讀部分較少,但可看到「sepia 每 ... 3–5(或 3–5 個手法)」等片段)。
二、逐行/區塊可讀文字(事實,盡可能精確抄錄)
- 標題:sepia
- 連結:English | 繁體中文
- 開頭段落(可讀片段):
- 「從真正會讓 AI 洗腦的層次下手。小說先修敘事架構,再破字句;專業文件(發版說明、PR 回覆、事故檢討、工單、技術文章)則按 venue 各用一套規則。」
- 下一段:
- 「這是一套可攜的 Agent Skill,支援 Claude Code、Codex、Grok Build 與 Antigravity。全平台共用唯一一份正典 SKILL.md,不另開平台分支。」
- 「四種操作: write、review(只診斷)、refactor(最小修改)、recreate(整體重寫)。」
- 標題:為什麼還需要另一個 humanizer
- 段落(可讀片段):
- 「常見的 humanizer 都在改用詞與句法。StoryScope(Russell et. al., 2026: 61,608 篇故事,涵蓋人類與 5 個頂尖 LLM)顯示,只靠敘事結構特徵的分類器就能以 93.2% macro-F1 偵測 AI 小說;把字句風格修掉,分類表現也只從 95.5% 降到 93.9%。留下的破綻都在敘事層: 敘事者直接講明主題,單線且因果收得過於工整的情節,情緒只靠身體感受呈現,沒有真實世界的參照,讀者缺席、時間呈線性,以及章節有成長與接納的收束。」
- 接下段(部分可讀):
- 「sepia 把這些差測距,連同 research/ 裡整理過的一篇相關研究,轉成小說寫作與修訂的三個 pass 流程:」
- 表格標題欄(可讀):Pass / 層次 / 例子
- 表格列(可讀要點,逐列):
- Pass 1 層次:敘事架構(小說)
- 例子(可讀片段):「別再解釋主題、鬆開因果鍵、把場景在後放、混用情緒呈現模式、稀疏的角色網絡、點名真實事物」 (句中部分詞可能有微差異)
- Pass 2 層次:篇章推進
- 例子(可讀片段):「拆掉段落—問題序列的模板、修掉故事中段的鬆垮、變換節奏與位置」 (部分片段有不確定)
- Pass 3 層次:字句風格
- 例子(可讀片段):「所有 humanizer 都在修的那一層:原...、句法模板、用詞、語域」 (句子有部分無法完全識別)
- 接續文字(可讀片段):
- 「另外 30 項特徵的診斷 rubric,以及各模型的指紋修正(Claude、GPT、Gemini、DeepSeek、Kimi)。」
- 再一段(可讀片段):
- 「專業文件會照的方式不同。研究指出,常見問題是沒有說服力;該下判斷時語氣保留,chatbot 殘留語氣、無視 venue 的語域,以及像同一個模子的口吻的排版。每種文件都有一份檢查表、再各配一份修改建議。」
- 第二個表格(欄位可讀):領域 / 要點
- 領域列出(可讀):發版說明 / 公告、PR / issue 回覆、事故檢討、工單、技術文章
- 「事故檢討」要點可讀:「對人不究責,對制度追根;附時間線、記錄過程、每個行動項目都有責任人。」
- 其他領域的要點在頁面可見但有多處字詞較模糊(下列「無法辨認」段落會逐一標出)。
- 頁面下方(結語片段,可讀):提到「sepia 每 ... 3–5 個手法,其餘略」等(具體數字與語句部分模糊)。
三、無法辨認或不確定的文字/片段(明確標示)
下面列出我在圖中無法清楚辨認或不確定的詞句,對應位置已標註以便查驗:
- 開頭段落的第一句中「從真正會讓 AI 洗腦的層次下手」句中「洗腦」是否為該字眼存在些微不確定,整句整體大意可辨但字詞有微量模糊。
- 「sepia 把這些差測距,連同 research/ 裡整理過的一篇相關研究,轉成...」中的「差測距」一詞不確定,可能為「差別測度」、「差異測距」或其他詞彙。
- 表格中各例子的具體用詞(例如 Pass1 的「點名真實事物」、Pass2 的「拆掉段落—問題序列的模板」等)有若干字詞模糊或被壓縮,句子結構上有小幅遺失。
- 表格「字句風格」那一行的例子中,首句片段「所有 humanizer 都在修的那:陳...」等詞不完整,部分詞彙無法逐字辨認。
- 第二個表格(領域/要點)中,「發版說明 / 公告」對應的要點多處字詞不清晰,像是「使用者需看懂前置、每項重要附佐證、不准行銷詞」雖可大略讀出,但有些詞是推測補全。
- 「PR / issue 回覆」一欄的要點有明顯斷行與模糊,能辨出「引用 file:line」等字,但整句無法完全還原。
- 頁面底部小字句整體較模糊,不能完整擷取。
四、推測(基於上下文的合理判斷,標明為推測)
- 推測 A:文章是一份工具或流程說明(名為 sepia),目的是把針對 AI 生成文本的「humanizer」方法改良為更關注敘事結構與專業文件風格的流程。
- 推測 B:表格中的三個 Pass 分別針對「大架構(敘事)」、「中層篇章進行(節奏/段落)」和「字句層(語句、用詞)」的修訂流程,並各自給出修改方向範例。
- 推測 C:提到的數據(61,608 篇、93.2% macro-F1、95.5%、93.9%)用以支持原有 humanizer 主要在字句層而非敘事層無法偵測的論點。
- 推測 D:第二個表格列出不同類型的專業文件(發版說明、PR 回覆、事故檢討、工單、技術文章)各自需要的修改要點或 checklist,例如事故檢討強調時序、過程記錄與責任人(這一點在圖中可較清楚辨認,故作為較高信心的推測)。
- 推測 E:文中提到「另外 30 項特徵的診斷 rubric」應為該系統提供的更細緻檢查項目清單,用於辨識或修正 AI 生成文本在敘事或專業文件上的缺陷。
五、其他可見界面元素(事實)
- 頁面右側有滾動條(代表為長頁面)。
- 版面為窄欄式內容區(頁面左右留白)。
- 字體為常見網頁字體,段落間有表格邊框與欄位陰影/分隔線。
如果你需要我把可辨認的全文按段落完整逐字轉錄(包括我在「無法辨認」中提及的不確定片段,我會以方括號標示不確定處),或需要我把表格內容以結構化的純文字表格呈現,請告訴我。我會基於圖像再做更精細的逐字轉錄並明確標注所有不確定字詞。
SkillPI 作品解读
用途:该素材描述一个名为 sepia 的开源写作 Skill,目的是通过调整文本的底层叙事结构来降低 AI 生成文本的“机器感”,适用于小说与各类专业文件(发版说明、PR/issue 回覆、事故检讨、工单、技术文章)。工具会输出诊断结果与模型特定的修正清单。
图片证据要点(基于可读文字):页面标题为 sepia,界面语言有 English 与 繁體中文 切换;页面呈现多处表格和三层 Pass 流程;图中提到 Russell et. al., 2026、61,608 篇故事与 93.2% macro-F1 等研究数据,并说明存在“另外 30 项特征的诊断 rubric”与各模型(Claude、GPT、Gemini、DeepSeek、Kimi)的指纹修正清单。页面列出四种操作模式:write、review(仅诊断)、refactor(最小修改)、recreate(整体重写),并提到可在 Claude Code、Codex、Grok Build、Antigravity 等平台以 Agent Skill 形式使用,且在仓库中以单一 SKILL.md 为正典。
关联 Skill 的使用步骤(依据页面可见流程与术语,按推断顺序整理,供复现前准备):
1) 准备:获取 sepia 仓库或 Skill(确认 SKILL.md 与它的说明),并准备待处理文本样本(小说或专业文件)。
2) 诊断(review):用 sepia 的诊断流程(包含 30 项特征的 rubric)对文本做结构性检测,生成问题清单与 Pass 推荐顺序(Pass 1-3)。
3) 选择操作模式:若仅需识别问题可停在 review;若要小修则选 refactor(最小修改);若需重构结构则选 recreate(整体重写);或直接使用 write 由 Skill 生成文本。工具会依据目标 LLM(如 Claude、GPT、Gemini、DeepSeek、Kimi)生成模型指纹相关的修改建议。
4) 执行修订:按照 Pass 1(叙事架构)→ Pass 2(篇章推进)→ Pass 3(字句风格)的顺序对文本进行调整,逐条应用诊断 rubric 的修正建议并复测。
5) 检验与迭代:对修订后文本重复诊断,确认被识别的“叙事层”问题是否被缓解,再决定是否进一步 refactor 或 recreate。
复现前提(需验证与准备项):
- 可获取 sepia 的源码或 Skill 定义(SKILL.md),以便安装/集成到 Agent 平台;
- 有可用的 Agent 运行环境或支持的适配器(页面提到 Claude Code、Codex、Grok Build、Antigravity);
- 待处理文本样本及对应场景(小说或具体的专业文件范例);
- 若要验证文中宣称的识别率,需要可比的评测数据集与复现 Russell et. al. 所用的实验设置及指标说明。
待核实项(页面可见但需进一步验证的具体点):
- sepia 仓库或下载位置与许可(页面指称为开源,但需核实代码仓库与安装步骤);
- 所谓“另外 30 項特徵的診斷 rubric” 的完整清单与具体判定规则;
- 模型指紋修正清單对不同 LLM(Claude、GPT、Gemini、DeepSeek、Kimi)的具体改写策略与示例;
- 引用的研究细节(Russell et. al., 2026)中 61,608 篇故事的来源、训练/测试分割与 93.2% macro‑F1 的评测方法,以便验证识别率可复现性;
- 与常见“humanizer”工具的定量对比数据(页面断言多工具仅修改词句层,sepia 改动更深层,但缺乏公开可比实验结果)。
注意事项:素材自身含有警示,称为“实验性开源工具,效果根据文本类型会有差异,仅供技术学习参考”。上述解释与使用步骤基于图中可见文字与合理推断,不构成对工具功能的实测确认。结论与核验项应以获取并检视 sepia 的源码和完整文档为准。