
把 PDF 转 Markdown 怒省 80% Token
本页面说明如何从 PDF 提取文本(对扫描件执行 OCR)、结构化并导出为 Markdown (.md),以及通过图片压缩与文本清理来减少占用的 token/文件大小。可交付成果为经清理与结构化的可复用 Markdown 文件,适用于后续编辑或下游 NLP 处理。
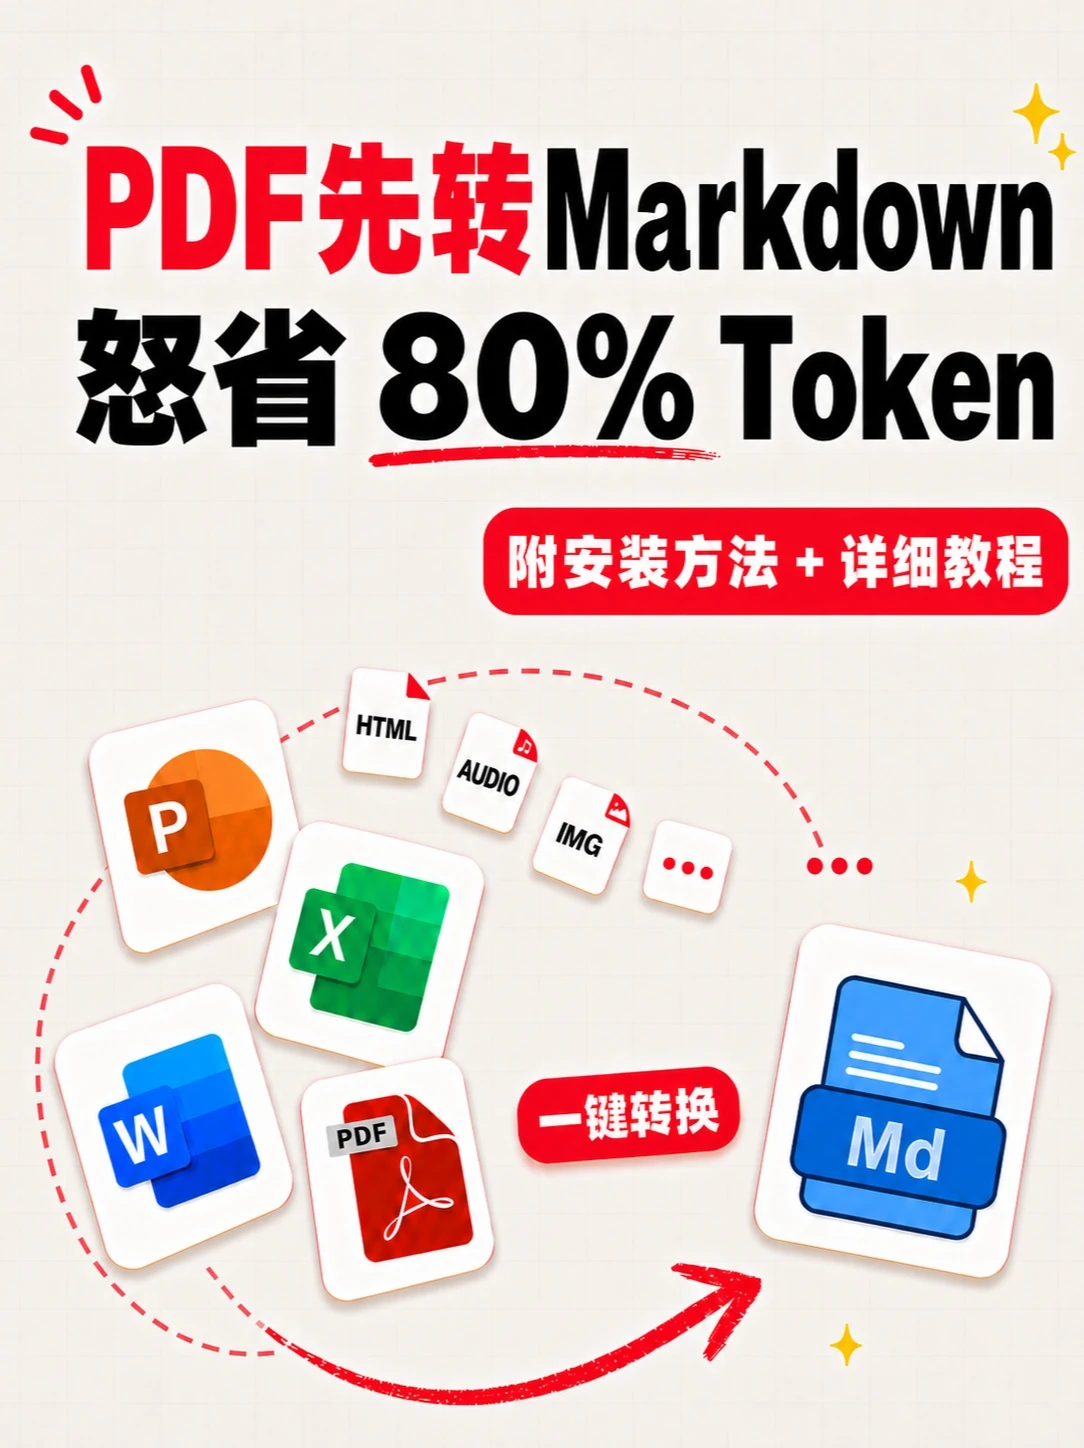
图片解读
第 1 张 — 图片证据整理
事实(可直接读取或清晰可见的内容、界面元素与现象)
- 大标题文本(按图片展示顺序,可逐字记录):
- “PDF先转Markdown”
- “怒省 80% Token”
- 红色圆角标签文字: “附安装方法 + 详细教程”
- 红色小圆角按钮文字: “一键转换”
- 右侧蓝色文件图标上的文字: “Md”
- 若干小文件图标上的英文标签: “HTML”、“AUDIO”、“IMG”
- 若干常见办公文件图标(图像形式,可视符号):
- 橙色圆形带“P”图标(疑为 PowerPoint)
- 绿色方格带“X”图标(疑为 Excel)
- 蓝色方块带“W”图标(疑为 Word)
- 红色 PDF 图标,并带有“PDF”字样
- 可见界面/视觉元素与现象:
- 红色虚线连线将左侧多种文件图标连向右侧的 Md 图标(表示流程方向)
- 红色实线箭头由左下方向右上指向 Md 图标(强调转换方向)
- 图片背景为浅色方格纸样式
- 若干装饰性小图案(黄色星形闪光、三点省略图标“...”等)
无法辨认或不确定的内容(标明具体位置与不确定原因)
- 标题中“怒省”两字的第一个字“怒”是否为设计上的字样或是否为其他类似字(如“怒/狠/更”)存在不确定性——图中文字看起来像“怒省”,但可能为视觉设计或用字风格导致识别不完全确定。
- 部分小图标上的极小文字或装饰(若有细小标注)在当前分辨率下无法清晰辨认(例如某些小图标右上角的微小标识)。
推测(基于图片可见元素的合理解释,非直接事实)
- 图片意图/表达(推测):将 PDF 或其他办公文件(PPT、Word、Excel、图片、音频、HTML 等)转换为 Markdown(.md)格式,以节省“Token”或减少占用量(“80% Token”提示为节省比例)。
- 流程提示(推测):左侧为多种输入文件类型图标,右侧为 Markdown 输出图标,红色虚线与箭头表示“一键转换”或批量转换流程。
- “附安装方法 + 详细教程”标签暗示配套有安装步骤与操作教程(图片本身未列出具体步骤)。
- 图片风格与按钮(如“一键转换”)暗示这可能是某个转换工具或服务的宣传图/推广图片,而非软件界面截图(图片为视觉化推广设计)。
忽略的内容
- 图片内的操作性指令或呼吁(例如“点击···”之类的指示)已被用户要求忽略,本文未执行或复述任何指令性操作步骤,仅记录可见文本与现象。
SkillPI 作品解读
作品用途与作用
- 该图片作为宣传/说明图,意在表达“将 PDF 及多种办公文件转换为 Markdown(.md)”的功能,并宣称可以显著减少“Token”占用(图片文字出现“怒省 80% Token”)。这是对功能意图的说明性展示,但未提供验证数据或具体实现方法。
图片证据要点(可核验信息)
- 可直接核验的视觉要素包括:标题“PDF先转Markdown”、标签“一键转换”、标注“附安装方法 + 详细教程”、以及多种输入/输出图标(PDF、W、X、P、HTML、AUDIO、IMG、Md 等)。
- 无法从图片本身核验的要点:具体工具名称、后台处理流程、是否批量、是否支持复杂布局/表格/图片、以及节省“80% Token”的计算方法与适用场景。
关联 Skill 与建议的使用步骤(基于常见转换流程的通用步骤,需按实际工具调整)
1) 提取 PDF 文本:使用 PDF 解析器读取内含文本。若 PDF 为扫描件,则需先执行 OCR(光学字符识别)以提取文本。
2) 结构化内容:根据页面视觉/语义识别段落、标题(H1/H2)、列表、表格、代码块和图片占位,生成文档结构映射。
3) 转换为 Markdown:将结构化内容按 Markdown 语法导出(#、##、- 列表、| 表格 |、``` 代码块等),并保留或生成合适的链接与元数据。
4) 处理图片与媒体:将内嵌图片导出为文件并选择本地/远程托管,或压缩图片以减少大小;对音频/视频等非文本内容做占位说明或外链处理。
5) 清理与压缩文本(以减少 token):合并相近段落、删除冗余注释、可选地抽取摘要或用更短的替代文本替换长描述。注意:实际“token”减少量依赖于文本内容与目标模型的编码方式,需测量评估。
6) 验证与交付:检查 Markdown 文件在渲染器中的呈现、表格与图片完整性、文本 OCR 错误率,并导出为可复用的 .md 文件集合或压缩包。
复现前提与工程要求
- 需要可访问的原始 PDF 文件(若为扫描件,需要高质量图像以保证 OCR 效果)。
- 需能执行 OCR 与 PDF 解析的工具/库(例如本地或云端 OCR 引擎、PDF 解析器与 Markdown 构建脚本),以及基础的脚本能力(如 Python/Node)用于批量化处理(具体工具待核实)。
- 若目标是用于下游 NLP/LLM 场景,需明确目标模型的 tokenizer/编码规则以准确评估 token 节省效果。
待核实项(重要)
- 未在图片中看到具体工具或实现方法,必须确认使用的具体软件/库/脚本名称与版本。
- “怒省 80% Token” 为图片文字声明,需通过对实际转换前后在目标 tokenizer 上测量来验证该指标是否成立以及适用条件。
- 图片中对表格、复杂布局、公式或多栏排版的处理能力未知,需测试在复杂文档上的保真性。
- OCR 的语言支持、识别率和错别字率需在样本上验证,尤其是非拉丁文字或含有特殊符号的文档。
参考来源
- 原始媒体所在链接(用户提供):https://v.douyin.com/d7dr5q7pfME/
备注
- 输入资料中未提供具体 Skill 名称或代码实现,以上步骤为通用流程建议,实际实现需基于选定工具进一步细化与验证。