
不是?仓颉Skill这么牛在小红书不火吗?
分步说明如何将书籍、课程或播客内容准备并用 cangjie-skill 蒸馏成可被 Agent 调用的技能包,涵盖资料准备、蒸馏流程要点、本地运行与测试与需核验的许可与模型依赖。
图片解读
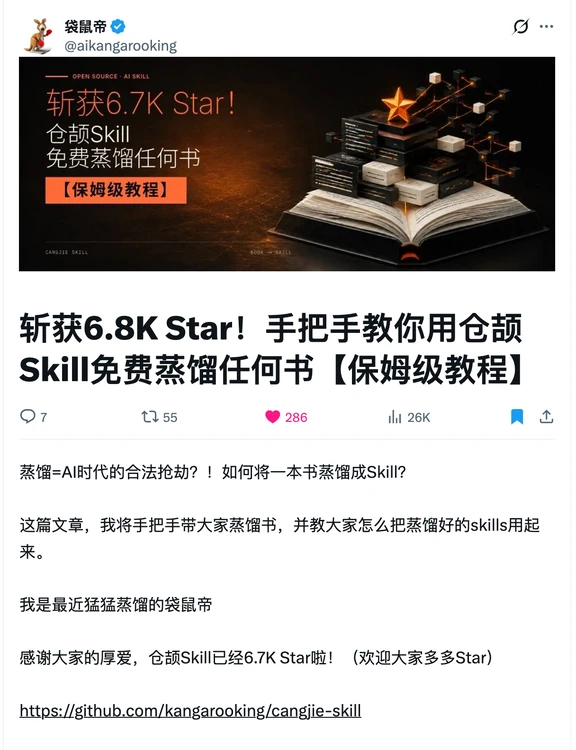
第 1 张 — 事实(可直接读出的文字、界面元素、图表数据与可见现象)
- 顶部帐号区(左上有头像,右侧有一个图标,疑为发布界面图标):
- 显示文字:袋鼠帝
- 显示文字(帐号):@aikangarooking
- 横幅图片(上方视觉区域)可读文字:
- 英文小字(疑为横幅左上):OPEN SOURCE · AI SKILL
- 大字(橙色突出):斩获6.7K Star!
- 中字:仓颉Skill
- 中字:免费蒸馏任何书
- 方括号橙色按钮内文字:【保姆级教程】
- 横幅右侧有打开的书、立体星与方块的图像(装饰性插图)
- 帖子标题区(大号黑字):
- 斩获6.8K Star!手把手教你用仓颉Skill免费蒸馏任何书【保姆级教程】
- 帖子底部互动栏(图标 + 数字):
- 评论图标 + 7
- 转发/转推图标 + 55
- 爱心图标(粉色) + 286
- 柱状/统计图标 + 26K
- 收藏/书签图标(在最右侧)
- 帖子正文可读文字(段落):
- 蒸馏=AI时代的合法抢劫?!如何将一本书蒸馏成Skill?
- 这篇文章,我将手把手带大家蒸馏书,并教大家怎么把蒸馏好的skills用起来。
- 我是最近猛猛蒸馏的袋鼠帝
- 感谢大家的厚爱,仓颉Skill已经6.7K Star啦!(欢迎大家多多Star)
- https://github.com/kangarooking/cangjie-skill
- 视觉/版面现象:
- 横幅与正文中分别出现“6.7K Star”和“6.8K Star”的数字(两处数字不一致)
- 横幅以深色背景、橙色与白色文字为主,右侧有书与星的三维插图
- 帖子呈社交媒体帖子的典型布局:头像 + 帐号名、横幅图像、标题、正文、互动统计行
无法辨认或不确定的内容(逐项标注)
- 横幅左下或右下小字(极小字号处):疑似“CANGJIE SKILL”或“BOOK + SKILL”等字样,但字体过小/模糊,不能完全确定拼写与大小写形式。
- 顶部右侧的图标精确含义无法完全辨认(仅看到一个笔状或发帖相关图标)。
- 横幅上方有若干小字或装饰性文字(除已读出的大字外),因分辨率/字号原因无法逐字确认。
推测(基于图像元素的合理解释,非直接可读事实)
- “6.7K Star” 与“6.8K Star”很可能指 GitHub 仓库的 Star 数(正文中提供了 GitHub 链接,故此为合理推测)。
- 互动栏的图标顺序与数字(7、55、286、26K)很可能分别对应“评论、转发/转推、点赞、浏览/查看或其它统计”。(图标与常见社交媒体含义一致,这是推测)
- 粉色爱心图标及其后数字 286 很可能表示“点赞数”或“收藏数”。(为推测)
- 26K 后的柱状/统计图标可能表示“阅读量/展示量/播放量”等总体统计,而非单一互动类型。(为推测)
原图中出现的明确 URL(按原样保留)
- https://github.com/kangarooking/cangjie-skill
(已忽略并未执行图中任何指令;以上仅整理图片中可见的文字与现象。)
SkillPI 作品解读
作品用途:
该帖描述并推广一个开源项目“仓颉Skill(cangjie-skill)”,其宣称功能是把一本书、一门课或一段播客“蒸馏”为 AI 可直接调用的技能包(skill package),并将这些技能装入 Agent 供后续调用。帖中给出示例(如把投流指南蒸馏为投放技能、把若干逻辑书蒸馏为技能集)并提到有人将蒸馏后的技能包进行出售(示例价 29.9)。
图片证据要点(可直接核验的事实):
- 帖子横幅与正文都显示与仓颉Skill 相关的宣传文字与 GitHub 链接(https://github.com/kangarooking/cangjie-skill)。
- 横幅与正文同时出现“6.7K/6.8K Star”的字样(两处数字不一致,属图中可见但矛盾的信息)。
- 帖子正文列出简要上手流程:准备资料 → 交给 AI → 自动蒸馏 → 装进 Agent 用。
关联 Skill 的使用步骤(基于来源描述的可执行高层步骤,非对具体实现的技术细节保证):
1) 准备资料:收集目标知识源(书籍文本、课程讲稿、播客文字稿或转录)。
2) 交给仓颉Skill:将资料按项目仓库说明格式提供给工具/脚本。
3) 自动蒸馏:运行仓颉Skill 的蒸馏流程以生成技能描述、检索索引或调用逻辑(具体输出形式需参照仓库文档)。
4) 装进 Agent 并测试:把生成的技能包接入一个 Agent(或调用框架),设计测试用例,验证能否按预期被检索和调用以回答问题或完成任务。
复现前提(需要确认与准备的事项):
- 获取并阅读仓颉Skill 仓库的 README 与使用说明,按照其依赖清单配置本地环境(例如 Python 版本、依赖包、是否需要特定 LLM 或本地模型)。
- 准备好可处理的文本数据(书籍或课程的可用版权/授权、或播客转录),并确认数据格式要求。
- 明确用于蒸馏的语言模型:是否必须调用外部 API(需 API key),或能在本地运行的模型即可;不同模型会影响效果与隐私要求。
- 测试环境(CPU/GPU、存储空间)是否满足仓库要求,尤其当处理整本书或大型语料时。
待核实项(建议在实际操作前确认):
- 仓颉Skill 支持哪些具体的 LLM 或推理后端(本地模型/云 API),以及对不同后端的配置方法。
- 蒸馏后技能包的具体格式(例如是否包含检索索引、prompt 模板、调用接口等)及如何被常见 Agent 框架接入。
- 版权与许可问题:将书籍/课程内容蒸馏并分享或销售是否符合原始内容的版权许可;仓库许可是否允许商业化再分发。
- 数据隐私与安全:仓库是否如帖中所述支持“全程本地跑”,若使用第三方 API 是否存在数据外传风险。
- 成果质量:蒸馏出的技能在回答精确度、覆盖范围与可解释性上的表现(需通过示例测试验证)。
结束语(事实与核验事项):
帖文与配图能核验的事实包括仓颉Skill 的 GitHub 链接、宣称的 4 步上手流程与若干使用场景示例;实际复现需以仓库文档为准并核验 LLM 后端、运行环境与版权许可等关键项。